§ Essay
Python3 高级教程
讲解 Python 基础(语法、高阶函数、回调、闭包、面向对象),Python 并发(多线程/多进程、线程池、进程池、GIL锁、asyncio 协程),CPython 解释器(内存模型、垃圾回收、GIL、内存泄漏/OOM 排查)
Python 是一个高层次的结合了解释性、编译性、互动性和面向对象的脚本语言。本文从最基础的 Python 语法写起,逐步讲解 Python 高级内容,带你彻底掌握 Python 。
一、Python3 介绍
前言
Python 的 3.0 版本,常被称为 Python 3000,或简称 Py3k。相对于 Python 的早期版本,这是一个较大的升级。为了不带入过多的累赘,Python 3.0 在设计的时候没有考虑向下兼容
官方宣布,2020 年 1 月 1 日, 停止 Python 2 的更新
简介
Python 是一个高层次的结合了解释性、编译性、互动性和面向对象的脚本语言
Python 的设计具有很强的可读性,相比其他语言经常使用英文关键字,其他语言的一些标点符号,它具有比其他语言更有特色语法结构
- Python 是一种解释型语言: 这意味着开发过程中没有了编译这个环节。类似于 PHP 和 Perl 语言
- Python 是交互式语言: 这意味着,您可以在一个 Python 提示符 >>> 后直接执行代码
- Python 是面向对象语言: 这意味着 Python 支持面向对象的风格或代码封装在对象的编程技术
- Python 是初学者的语言: Python 对初级程序员而言,是一种伟大的语言,它支持广泛的应用程序开发,从简单的文字处理到 WWW 浏览器再到游戏
Python 发展历史
Python 是由 Guido van Rossum 在八十年代末和九十年代初,在荷兰国家数学和计算机科学研究所设计出来的
Python 本身也是由诸多其他语言发展而来的,这包括 ABC、Modula-3、C、C++、Algol-68、SmallTalk、Unix shell 和其他的脚本语言等等
像 Perl 语言一样,Python 源代码同样遵循 GPL(GNU General Public License)协议
现在 Python 是由一个核心开发团队在维护,Guido van Rossum 仍然占据着至关重要的作用,指导其进展
Python 2.0 于 2000 年 10 月 16 日发布,增加了实现完整的垃圾回收,并且支持 Unicode
Python 3.0 于 2008 年 12 月 3 日发布,此版不完全兼容之前的 Python 源代码。不过,很多新特性后来也被移植到旧的 Python 2.6/2.7版本
Python 3.0 版本,常被称为 Python 3000,或简称 Py3k。相对于 Python 的早期版本,这是一个较大的升级
Python 2.7 被确定为最后一个 Python 2.x 版本,它除了支持 Python 2.x 语法外,还支持部分 Python 3.1 语法
Python 特点
- 易于学习:Python有相对较少的关键字,结构简单,和一个明确定义的语法,学习起来更加简单
- 易于阅读:Python代码定义的更清晰
- 易于维护:Python的成功在于它的源代码是相当容易维护的
- 一个广泛的标准库:Python的最大的优势之一是丰富的库,跨平台的,在UNIX,Windows和Macintosh兼容很好
- 互动模式:互动模式的支持,您可以从终端输入执行代码并获得结果的语言,互动的测试和调试代码片断。
- 可移植:基于其开放源代码的特性,Python已经被移植(也就是使其工作)到许多平台
- 可扩展:如果你需要一段运行很快的关键代码,或者是想要编写一些不愿开放的算法,你可以使用 C 或 C++ 完成那部分程序,然后从你的 Python 程序中调用
- 数据库:sPython 提供所有主要的商业数据库的接口
- GUI编程:Python 支持 GUI 可以创建和移植到许多系统调用
- 可嵌入: 你可以将 Python 嵌入到 C/C++ 程序,让你的程序的用户获得”脚本化”的能力
Python 应用
- Youtube - 视频社交网站
- Reddit - 社交分享网站
- Dropbox - 文件分享服务
- 豆瓣网 - 图书、唱片、电影等文化产品的资料数据库网站
- 知乎 - 一个问答网站
- 果壳 - 一个泛科技主题网站
- Bottle - Python微Web框架
- EVE - 网络游戏EVE大量使用Python进行开发
- Blender - 使用Python作为建模工具与GUI语言的开源3D绘图软件
- Inkscape - 一个开源的SVG矢量图形编辑器。
- …
二、Python 入门语法
1、编码
默认情况下,Python3 源码文件以 UTF-8 编码,所有字符串都是 unicode 字符串
当然你也可以为源码文件指定不同的编码:
# -*- coding: cp-1252 -*-上述定义允许在源文件中使用 Windows-1252 字符集中的字符编码,对应适合语言为保加利亚语、白俄罗斯语、马其顿语、俄语、塞尔维亚语
2、标识符
- 第一个字符必须以字母(a-z, A-Z)或下划线 _
- 标识符的其他的部分由字母、数字和下划线组成
- 标识符对大小写敏感,count 和 Count 是不同的标识符
- 标识符对长度无硬性限制,但建议保持简洁(一般不超过 20 个字符)
- 禁止使用保留关键字,如 if、for、class 等不能作为标识符
(1)合法标识符:
age = 25                # 普通变量名,最常见
user_name = "Alice"     # 用下划线连接单词,清晰易读
_total = 100            # 下划线开头通常表示“内部使用”或“私有”
MAX_SIZE = 1024         # 全大写通常表示“常量”(固定不变的值)
calculate_area()        # 函数名,动词+名词
StudentInfo             # 类名,首字母大写(驼峰命名法)
__private_var           # 双下划线开头,有特殊含义
(2)非法标识符:
2nd_place = "silver"    # 错误:以数字开头
user-name = "Bob"       # 错误:包含连字符
class = "Math"          # 错误:使用关键字
$price = 9.99           # 错误:包含特殊字符
for = "loop"            # 错误:使用关键字
Python 3 允许使用 Unicode 字符作为标识符,可以用中文作为变量名,非 ASCII 标识符也是允许的了
姓名 = "张三"   # 合法
π = 3.14159    # 合法
测试标识符是否合法:
def is_valid_identifier(name):
    try:
        exec(f"{name} = None")
        return True
    except:
        return False

print(is_valid_identifier("2var"))  # False
print(is_valid_identifier("var2"))  # True
3、Python 保留关键字
保留字即关键字,我们不能把它们用作任何标识符名称。Python 的标准库提供了一个 keyword 模块,可以输出当前版本的所有关键字:
>>> import keyword
>>> keyword.kwlist
['False', 'None', 'True', 'and', 'as', 'assert', 'async', 'await', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try', 'while', 'with', 'yield']| 类别 | 关键字 | 说明 |
|---|---|---|
| 逻辑值 | True | 布尔真值 |
False | 布尔假值 | |
None | 表示空值或无值 | |
| 逻辑运算 | and | 逻辑与运算 |
or | 逻辑或运算 | |
not | 逻辑非运算 | |
| 条件控制 | if | 条件判断语句 |
elif | 否则如果(else if 的缩写) | |
else | 否则分支 | |
| 循环控制 | for | 迭代循环 |
while | 条件循环 | |
break | 跳出循环 | |
continue | 跳过当前循环的剩余部分,进入下一次迭代 | |
| 异常处理 | try | 尝试执行代码块 |
except | 捕获异常 | |
finally | 无论是否发生异常都会执行的代码块 | |
raise | 抛出异常 | |
| 函数定义 | def | 定义函数 |
return | 从函数返回值 | |
lambda | 创建匿名函数 | |
| 类与对象 | class | 定义类 |
del | 删除对象引用 | |
| 模块导入 | import | 导入模块 |
from | 从模块导入特定部分 | |
as | 为导入的模块或对象创建别名 | |
| 作用域 | global | 声明全局变量 |
nonlocal | 声明非局部变量(用于嵌套函数) | |
| 异步编程 | async | 声明异步函数 |
await | 等待异步操作完成 | |
| 其他 | assert | 断言,用于测试条件是否为真 |
in | 检查成员关系 | |
is | 检查对象身份(是否是同一个对象) | |
pass | 空语句,用于占位 | |
with | 上下文管理器,用于资源管理 | |
yield | 从生成器函数返回值 |
4、注释
# 单行注释

"""
多行注释 1
多行注释 1
"""

'''
多行注释 2
多行注释 2
'''多行注释实际上是一个字符串,我们只要不使用它,它不会影响程序的运行,这种注释方式不能嵌套使用,当你开始一个多行注释块时,Python 会一直将后续的行都当作注释,直到遇到另一组三个单引号或三个双引号
'''
这是外部的多行注释
可以包含一些描述性的内容
    '''
    这是尝试嵌套的多行注释
    会导致语法错误
    '''
'''
正确写法:
'''
这是外部的多行注释
可以包含一些描述性的内容

# 这是内部的单行注释
# 可以嵌套在多行注释中
'''
5、行与缩进
python 最具特色的就是使用缩进来表示代码块,不需要使用大括号 {} ,缩进的空格数是可变的,但是同一个代码块的语句必须包含相同的缩进空格数
if True:
    print ("True")
else:
    print ("False")
缩进相同的一组语句构成一个代码块,我们称之代码组
像 if、while、def 和 class 这样的复合语句,首行以关键字开始,以冒号( : )结束,该行之后的一行或多行代码构成代码组
我们将首行及后面的代码组称为一个子句(clause)
6、空行
函数之间或类的方法之间用空行分隔,表示一段新的代码的开始。类和函数入口之间也用一行空行分隔,以突出函数入口的开始
空行并不是 Python 语法的一部分,作用在于分隔两段不同功能或含义的代码
**记住:**空行也是程序代码的一部分
7、多行语句
Python 通常是一行写完一条语句,但如果语句很长,我们可以使用反斜杠 \ 来实现多行语句,例如:
total = item_one + \
        item_two + \
        item_three
在 [], {}, 或 () 中的多行语句,不需要使用反斜杠 \ ,例如:
total = ['item_one', 'item_two', 'item_three',
        'item_four', 'item_five']
8、同一行显示多条语句
Python 可以在同一行中使用多条语句,语句之间使用分号 ; 分割,以下是一个简单的实例:
import sys; x = 'runoob'; sys.stdout.write(x + '\n')9、input 等待用户输入
input("输入:")10、print 输出
print 默认输出是换行的,如果要实现不换行需要在变量末尾加上 end="":
print(1, end=" " )
print(2, end=" " )
11、import 与 from…import
在 python 用 import 或者 from…import 来导入相应的模块
# 将整个模块(somemodule)导入
import somemodule

# 从某个模块中导入某个函数
from somemodule import somefunction

# 从某个模块中导入多个函数
from somemodule import firstfunc, secondfunc, thirdfunc

# 将某个模块中的全部函数导入
from somemodule import *
12、命令行参数
很多程序可以执行一些操作来查看一些基本信息,Python 可以使用 -h 参数查看各参数帮助信息:
$ python -h
usage: python [option] ... [-c cmd | -m mod | file | -] [arg] ...
Options and arguments (and corresponding environment variables):
-c cmd : program passed in as string (terminates option list)
-d     : debug output from parser (also PYTHONDEBUG=x)
-E     : ignore environment variables (such as PYTHONPATH)
-h     : print this help message and exit

[ etc. ]
三、基本数据类型
Python 中的变量不需要声明。每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建
在 Python 中,变量就是变量,它没有类型,我们所说的类型是变量所指的内存中对象的类型
(1)赋值
a = 1(2)多个变量赋值
a = b = c = 1(3)查看变量的类型
x = False
print(type(x))
# <class 'bool'>

a = False
print(isinstance(a, int))
# True
isinstance 和 type 的区别在于:
type()不会认为子类是一种父类类型isinstance()会认为子类是一种父类类型
**注意:**Python3 中,bool 是 int 的子类,True 和 False 可以和数字相加
1、标准数据类型
Python3 中有 6 种标准数据类型,以及 bool 布尔类型(bool 是 int 的子类,有时单独列出):
- Number(数字)
- String(字符串)
- bool(布尔类型)
- List(列表)
- Tuple(元组)
- Set(集合)
- Dictionary(字典)
按是否可变,可以分为以下两类:
- **不可变数据(4 个):**Number(数字)、String(字符串)、bool(布尔)、Tuple(元组)
- **可变数据(3 个):**List(列表)、Dictionary(字典)、Set(集合)
此外还有一些高级的数据类型,如字节数组类型 bytes
2、Number(数字)
数字数据类型用于存储数值
Python3 支持 int、float、bool、complex(复数)
在 Python 3 里,只有一种整数类型 int,表示为长整型
当你指定一个值时,Number 对象就会被创建:
var = 1可以使用 del 语句删除对象引用:
del var
print(var)
# name 'var' is not defined.
(1)数值运算
+ - * / ** //注意:
- Python 可以同时为多个变量赋值,如
a, b = 1, 2 - 一个变量可以通过赋值指向不同类型的对象
- 数值的除法包含两个运算符:/ 返回一个浮点数,// 返回一个整数(向下取整)
- 在混合计算时,Python 会把整型自动转换为浮点数
- Python 3 中整数字面量不允许前导零(如
080),八进制数必须使用0o前缀(如0o17),十六进制使用0x前缀(如0x69),二进制使用0b前缀 - 数据类型是不允许改变的,这就意味着如果改变数字数据类型的值,将重新分配内存空间
(2)数字类型转换
- int(x) 将x转换为一个整数
- float(x) 将x转换到一个浮点数
- complex(x) 将x转换到一个复数,实数部分为 x,虚数部分为 0
- complex(x, y) 将 x 和 y 转换到一个复数,实数部分为 x,虚数部分为 y。x 和 y 是数字表达式
(3)数学函数
| 函数 | 返回值 ( 描述 ) |
|---|---|
| abs(x) | 返回数字的绝对值,如abs(-10) 返回 10 |
| ceil(x) | 返回数字的上入整数,如math.ceil(4.1) 返回 5 |
| cmp(x, y) | 如果 x < y 返回 -1, 如果 x == y 返回 0, 如果 x > y 返回 1。 Python 3 已废弃,使用 (x>y)-(x<y) 替换 |
| exp(x) | 返回e的x次幂(ex),如math.exp(1) 返回2.718281828459045 |
| fabs(x) | 以浮点数形式返回数字的绝对值,如math.fabs(-10) 返回10.0 |
| floor(x) | 返回数字的下舍整数,如math.floor(4.9)返回 4 |
| log(x) | 如math.log(math.e)返回1.0,math.log(100,10)返回2.0 |
| log10(x) | 返回以10为基数的x的对数,如math.log10(100)返回 2.0 |
| max(x1, x2,…) | 返回给定参数的最大值,参数可以为序列 |
| min(x1, x2,…) | 返回给定参数的最小值,参数可以为序列 |
| modf(x) | 返回x的整数部分与小数部分,两部分的数值符号与x相同,整数部分以浮点型表示 |
| pow(x, y) | x**y 运算后的值 |
| round(x ,n) | 返回浮点数 x 的四舍五入值,如给出 n 值,则代表舍入到小数点后的位数。其实准确的说是保留值将保留到离上一位更近的一端 |
| sqrt(x) | 返回数字x的平方根 |
(4)随机数函数
随机数可以用于数学,游戏,安全等领域中,还经常被嵌入到算法中,用以提高算法效率,并提高程序的安全性
| 函数 | 描述 |
|---|---|
| choice(seq) | 从序列的元素中随机挑选一个元素,比如random.choice(range(10)),从0到9中随机挑选一个整数 |
| randrange (start, stop ,step) | 从指定范围内,按指定基数递增的集合中获取一个随机数,基数默认值为 1 |
| random() | 随机生成下一个实数,它在[0,1)范围内 |
| seed(x) | 改变随机数生成器的种子seed。如果你不了解其原理,你不必特别去设定seed,Python会帮你选择seed |
| shuffle(lst) | 将序列的所有元素随机排序 |
| uniform(x, y) | 随机生成下一个实数,它在[x,y]范围内 |
(5)三角函数
| 函数 | 描述 |
|---|---|
| acos(x) | 返回x的反余弦弧度值 |
| asin(x) | 返回x的反正弦弧度值 |
| atan(x) | 返回x的反正切弧度值 |
| atan2(y, x) | 返回给定的 X 及 Y 坐标值的反正切值 |
| cos(x) | 返回x的弧度的余弦值 |
| hypot(x, y) | 返回欧几里德范数 sqrt(xx + yy) |
| sin(x) | 返回的x弧度的正弦值 |
| tan(x) | 返回x弧度的正切值 |
| degrees(x) | 将弧度转换为角度,如degrees(math.pi/2) , 返回90.0 |
| radians(x) | 将角度转换为弧度 |
(6)数学常量
| 常量 | 描述 |
|---|---|
| pi | 数学常量 pi(圆周率,一般以π来表示) |
| e | 数学常量 e,e即自然常数(自然常数) |
3、String(字符串)
Python 中的字符串用单引号 ’ 或双引号 ” 括起来,同时使用反斜杠 \ 转义特殊字符
字符串截取的语法格式如下:
变量[头下标:尾下标]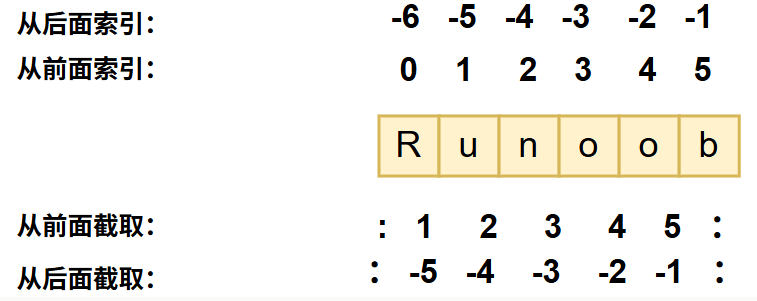
加号 + 是字符串的连接符,星号 ***** 表示复制当前字符串,与之结合的数字为复制的次数
str1 = "hello"

print(str1 * 2)         # 重复打印两次:hellohello
print(str1 + "world")   # 字符串拼接:helloworld
注意,Python 没有单独的字符类型,一个字符就是长度为 1 的字符串
Python 字符串不能被改变,向一个索引位置赋值,比如 word[0] = ‘m’ 会导致错误
Python 使用反斜杠 \ 转义特殊字符,如果你不想让反斜杠发生转义,可以在字符串前面添加一个 r,表示原始字符串:
print('Ru\noob')
# Ru
# oob

print(r'Ru\noob')
# Ru\noob
另外,反斜杠(\)可以作为续行符,表示下一行是上一行的延续。也可以使用 """…""" 或者 '''…''' 跨越多行
total = 1 + 2 + 3 + \
        4 + 5 + 6
print(total)
# 21

b = """Hello
World"""
print(b)
# Hello
# World
(1)转义字符
| 转义字符 | 描述 |
|---|---|
| \ (在行尾时) | 续行符 |
| \ \ | 反斜杠符号 |
| \ ‘ | 单引号 |
| \ “ | 双引号 |
| \a | 响铃 |
| \b | 退格(Backspace) |
| \000 | 空 |
| \n | 换行 |
| \v | 纵向制表符 |
| \t | 横向制表符 |
| \r | 回车 |
| \f | 换页 |
| \yyy | 八进制数 |
| \xyy | 十六进制数 |
| \other | 其它的字符以普通格式输出 |
实例:
# \a 响铃
print("\a")
# 执行后电脑有响声

# \b 退格
print("Hello \b World!")
# Hello World!

# \r 回车
# 将 \r 后面的内容移到字符串开头,并逐一替换开头部分的字符,直至将 \r 后面的内容完全替换完成
print("Hello\rWorld!")
# World!

# \yyy 八进制数
# y 代表 0~7 的字符
print("\110\145\154\154\157\40\127\157\162\154\144\41")
# Hello World!

# \xyy 十六进制数
# 以 \x 开头,y 代表的字符
print("\x48\x65\x6c\x6c\x6f\x20\x57\x6f\x72\x6c\x64\x21")
# Hello World!

# 添加进度条图形和百分比
import time
for i in range(101):
    bar = '[' + '=' * (i // 2) + ' ' * (50 - i // 2) + ']'
    print(f"\r{bar} {i:3}%", end='', flush=True)
    time.sleep(0.05)
print()
(2)字符串运算符
| 操作符 | 描述 |
|---|---|
| + | 字符串连接 |
| * | 重复输出字符串 |
| [] | 通过索引获取字符串中字符 |
| [ : ] | 截取字符串中的一部分,遵循左闭右开原则 |
| in | 成员运算符 |
| not in | 成员运算符 |
| r/R | 原始字符串,所有的字符串都是直接按照字面的意思来使用 |
| % | 格式字符串 |
(3)字符串格式化
| 符 号 | 描述 |
|---|---|
| %c | 格式化字符及其ASCII码 |
| %s | 格式化字符串 |
| %d | 格式化整数 |
| %u | 格式化无符号整型 |
| %o | 格式化无符号八进制数 |
| %x | 格式化无符号十六进制数 |
| %X | 格式化无符号十六进制数(大写) |
| %f | 格式化浮点数字,可指定小数点后的精度 |
| %e | 用科学计数法格式化浮点数 |
| %E | 作用同%e,用科学计数法格式化浮点数 |
| %g | %f和%e的简写 |
| %G | %f 和 %E 的简写 |
| %p | 用十六进制数格式化变量的地址 |
例子:
print ("我叫 %s 今年 %d 岁!" % ('小明', 10))(4)格式化操作符辅助指令
| 符号 | 功能 |
|---|---|
| * | 定义宽度或者小数点精度 |
| - | 用做左对齐 |
| + | 在正数前面显示加号( + ) |
| < sp > | 在正数前面显示空格 |
| # | 在八进制数前面显示零(‘0’),在十六进制前面显示’0x’或者’0X’(取决于用的是’x’还是’X’) |
| 0 | 显示的数字前面填充’0’而不是默认的空格 |
| % | ’%%‘输出一个单一的’%‘ |
| (var) | 映射变量(字典参数) |
| m.n. | m 是显示的最小总宽度,n 是小数点后的位数(如果可用的话) |
Python2.6 开始,新增了一种格式化字符串的函数 str.format(),它增强了字符串格式化的功能
(5)三引号
python 三引号允许一个字符串跨多行,字符串中可以包含换行符、制表符以及其他特殊字符
para_str = """这是一个多行字符串的实例
多行字符串可以使用制表符
TAB ( \t )。
也可以使用换行符 [ \n ]。
"""
print (para_str)
"""
这是一个多行字符串的实例
多行字符串可以使用制表符
TAB (    )。
也可以使用换行符 [
 ]。
"""
三引号让程序员从引号和特殊字符串的泥潭里面解脱出来,自始至终保持一小块字符串的格式是所谓的WYSIWYG(所见即所得)格式的
一个典型的用例是,当你需要一块HTML或者SQL时,这时用字符串组合,特殊字符串转义将会非常的繁琐
(6)f-string
f-string 是 python3.6 之后版本添加的,称之为字面量格式化字符串,是新的格式化字符串的语法。
之前我们习惯用百分号 (%):
name = 'world'
name1 = 'Hello %s' % name
print(name1)
# Hello world
f-string 格式化字符串以 f 开头,后面跟着字符串,字符串中的表达式用大括号 {} 包起来,它会将变量或表达式计算后的值替换进去,实例如下:
name = 'Runoob'
print(f'Hello {name}')  # 替换变量
# Hello Runoob

print(f'{1+2}')         # 使用表达式
# 3

w = {'name': 'baidu', 'url': 'www.baidu.com'}
print(f'{w["name"]}: {w["url"]}')
# baidu: www.baidu.com
用了这种方式明显更简单了,不用再去判断使用 %s,还是 %d
在 Python 3.8 的版本中可以使用 = 符号来拼接运算表达式与结果:
x = 1
print(f'{x+1}')    # Python 3.6
# 2

y = 1
print(f'{y+1=}')   # Python 3.8
# y+1=2
(7)Unicode 字符串
在 Python2 中,普通字符串是以8位ASCII码进行存储的,而 Unicode 字符串则存储为 16 位 unicode 字符串,这样能够表示更多的字符集。使用的语法是在字符串前面加上前缀 u
在Python3中,所有的字符串都是Unicode字符串
(8)Python 的字符串内建函数
| 序号 | 方法及描述 |
|---|---|
| 1 | capitalize() 将字符串的第一个字符转换为大写 |
| 2 | center(width, fillchar) 返回一个指定的宽度 width 居中的字符串,fillchar 为填充的字符,默认为空格 |
| 3 | count(str, beg= 0,end=len(string)) 返回 str 在 string 里面出现的次数,如果 beg 或者 end 指定则返回指定范围内 str 出现的次数 |
| 4 | bytes.decode(encoding=“utf-8”, errors=“strict”) Python3 中没有 decode 方法,但我们可以使用 bytes 对象的 decode() 方法来解码给定的 bytes 对象,这个 bytes 对象可以由 str.encode() 来编码返回 |
| 5 | encode(encoding=‘UTF-8’,errors=‘strict’) 以 encoding 指定的编码格式编码字符串,如果出错默认报一个ValueError 的异常,除非 errors 指定的是’ignore’或者’replace’ |
| 6 | endswith(suffix, beg=0, end=len(string)) 检查字符串是否以 suffix 结束,如果 beg 或者 end 指定则检查指定的范围内是否以 suffix 结束,如果是,返回 True,否则返回 False |
| 7 | expandtabs(tabsize=8) 把字符串 string 中的 tab 符号转为空格,tab 符号默认的空格数是 8 |
| 8 | find(str, beg=0, end=len(string)) 检测 str 是否包含在字符串中,如果指定范围 beg 和 end ,则检查是否包含在指定范围内,如果包含返回开始的索引值,否则返回-1 |
| 9 | index(str, beg=0, end=len(string)) 跟find()方法一样,只不过如果str不在字符串中会报一个异常 |
| 10 | isalnum() 检查字符串是否由字母和数字组成,即字符串中的所有字符都是字母或数字。如果字符串至少有一个字符,并且所有字符都是字母或数字,则返回 True;否则返回 False |
| 11 | isalpha() 如果字符串至少有一个字符并且所有字符都是字母或中文字则返回 True, 否则返回 False |
| 12 | isdigit() 如果字符串只包含数字则返回 True 否则返回 False |
| 13 | islower() 如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是小写,则返回 True,否则返回 False |
| 14 | isnumeric() 如果字符串中只包含数字字符,则返回 True,否则返回 False |
| 15 | isspace() 如果字符串中只包含空白,则返回 True,否则返回 False |
| 16 | istitle() 如果字符串是标题化的(见 title())则返回 True,否则返回 False |
| 17 | isupper() 如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是大写,则返回 True,否则返回 False |
| 18 | join(seq) 以指定字符串作为分隔符,将 seq 中所有的元素(的字符串表示)合并为一个新的字符串 |
| 19 | len(string) 返回字符串长度 |
| 20 | ljust(width, fillchar) 返回一个原字符串左对齐,并使用 fillchar 填充至长度 width 的新字符串,fillchar 默认为空格 |
| 21 | lower() 转换字符串中所有大写字符为小写 |
| 22 | lstrip() 截掉字符串左边的空格或指定字符 |
| 23 | maketrans() 创建字符映射的转换表,对于接受两个参数的最简单的调用方式,第一个参数是字符串,表示需要转换的字符,第二个参数也是字符串表示转换的目标 |
| 24 | max(str) 返回字符串 str 中最大的字母 |
| 25 | min(str) 返回字符串 str 中最小的字母 |
| 26 | replace(old, new, max) 把 将字符串中的 old 替换成 new,如果 max 指定,则替换不超过 max 次 |
| 27 | rfind(str, beg=0,end=len(string)) 类似于 find()函数,不过是从右边开始查找 |
| 28 | rindex( str, beg=0, end=len(string)) 类似于 index(),不过是从右边开始 |
| 29 | rjust(width, fillchar) 返回一个原字符串右对齐,并使用fillchar(默认空格)填充至长度 width 的新字符串 |
| 30 | rstrip() 删除字符串末尾的空格或指定字符 |
| 31 | split(str="", num=string.count(str)) 以 str 为分隔符截取字符串,如果 num 有指定值,则仅截取 num+1 个子字符串 |
| 32 | splitlines(keepends) 按照行(‘\r’, ‘\r\n’, \n’)分隔,返回一个包含各行作为元素的列表,如果参数 keepends 为 False,不包含换行符,如果为 True,则保留换行符 |
| 33 | startswith(substr, beg=0,end=len(string)) 检查字符串是否是以指定子字符串 substr 开头,是则返回 True,否则返回 False。如果beg 和 end 指定值,则在指定范围内检查 |
| 34 | strip(chars) 在字符串上执行 lstrip()和 rstrip() |
| 35 | swapcase() 将字符串中大写转换为小写,小写转换为大写 |
| 36 | title() 返回”标题化”的字符串,就是说所有单词都是以大写开始,其余字母均为小写(见 istitle()) |
| 37 | translate(table, deletechars="") 根据 table 给出的表(包含 256 个字符)转换 string 的字符, 要过滤掉的字符放到 deletechars 参数中 |
| 38 | upper() 转换字符串中的小写字母为大写 |
| 39 | zfill (width) 返回长度为 width 的字符串,原字符串右对齐,前面填充0 |
| 40 | isdecimal() 检查字符串是否只包含十进制字符,如果是返回 true,否则返回 false |
4、bool(布尔类型)
布尔类型即 True 或 False。在 Python 中,True 和 False 都是关键字,表示布尔值
特点:
-
布尔类型只有两个值:True 和 False
-
bool 是 int 的子类,因此布尔值可以被看作整数来使用,其中 True 等价于 1,False 等价于 0
-
布尔类型可以和其他数据类型进行比较,比如数字、字符串等。在比较时,Python 会将 True 视为 1,False 视为 0
-
布尔类型可以和逻辑运算符一起使用,包括
and、or和not,用来组合多个布尔表达式 -
布尔类型也可以被转换成其他数据类型,比如整数、浮点数和字符串。在转换时,True 会被转换成 1,False 会被转换成 0
-
可以使用
bool()函数将其他类型的值转换为布尔值。1)以下值转换为布尔值时为
False:None、False、零(0、0.0、0j)、空序列(如''、()、[])和空映射(如{})2)其他所有值转换为布尔值时均为
True
5、List(列表)
序列是 Python 中最基本的数据结构,序列中的每个值都有对应的位置值,称之为索引,第一个索引是 0,第二个索引是 1,依此类推。Python 有 6 个序列的内置类型,但最常见的是列表和元组。列表都可以进行的操作包括索引,切片,加,乘,检查成员。此外,Python 已经内置确定序列的长度以及确定最大和最小的元素的方法。
(1)基础用法
列表是最常用的 Python 数据类型,它可以作为一个方括号内的逗号分隔值出现。
列表的数据项不需要具有相同的类型
创建一个列表,只要把逗号分隔的不同的数据项使用方括号括起来即可。如下所示:
List(列表)是 Python 中使用最频繁的数据类型
列表可以完成大多数集合类的数据结构实现。列表中元素的类型可以不相同,也可以嵌套列表
和字符串一样,列表同样可以被索引和截取,列表被截取后返回一个包含所需元素的新列表,不同的是列表中的元素是可以改变的
变量[头下标:尾下标]加号 + 是列表连接运算符,星号 ***** 是重复操作。如下实例:
list1 = ['abc', 123]
list2 = [456, 'def']

print(list1 * 2)
# ['abc', 123, 'abc', 123]

print(list1 + list2)
# ['abc', 123, 456, 'def']
Python 列表截取可以接收第三个参数,参数作用是截取的步长
如果第三个参数为负数表示逆向读取
list1 = [1, 2, 3, 4, 5, 6]
print(list1[5:0:-2])
# [6, 4, 2]
(2)删除列表元素
list = ['1', '2', 3, 4]

print ("原始列表 : ", list)
# 原始列表 :  ['1', '2', 3, 4]

del list[2]
print ("删除第三个元素 : ", list)
# 删除第三个元素 :  ['1', '2', 4]
(3)列表脚本操作符
| Python 表达式 | 结果 | 描述 |
|---|---|---|
| len([1, 2, 3]) | 3 | 长度 |
| [1, 2, 3] + [4, 5, 6] | [1, 2, 3, 4, 5, 6] | 组合 |
| [‘Hi!’] * 4 | [‘Hi!’, ‘Hi!’, ‘Hi!’, ‘Hi!’] | 重复 |
| 3 in [1, 2, 3] | True | 元素是否存在于列表中 |
| for x in [1, 2, 3]: print(x, end=” “) | 1 2 3 | 迭代 |
(4)列表比较
列表比较需要引入 operator 模块的 eq 方法
import operator

a = [1, 2]
b = [2, 3]
c = [2, 3]
print("operator.eq(a,b): ", operator.eq(a,b))
# operator.eq(a,b):  False

print("operator.eq(c,b): ", operator.eq(c,b))
# operator.eq(c,b):  True
(5)列表函数 & 方法
函数:
| 序号 | 函数 |
|---|---|
| 1 | len(list)] 列表元素个数 |
| 2 | max(list) 返回列表元素最大值 |
| 3 | min(list) 返回列表元素最小值 |
| 4 | list(seq) 将元组转换为列表 |
方法:
| 序号 | 方法 |
|---|---|
| 1 | list.append(obj) 在列表末尾添加新的对象 |
| 2 | list.count(obj) 统计某个元素在列表中出现的次数 |
| 3 | list.extend(seq) 在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表) |
| 4 | list.index(obj) 从列表中找出某个值第一个匹配项的索引位置 |
| 5 | list.insert(index, obj) 将对象插入列表 |
| 6 | list.pop(index=-1) 移除列表中的一个元素(默认最后一个元素),并且返回该元素的值 |
| 7 | list.remove(obj) 移除列表中某个值的第一个匹配项 |
| 8 | list.reverse() 反向列表中元素 |
| 9 | list.sort( key=None, reverse=False) 对原列表进行排序 |
| 10 | list.clear() 清空列表 |
| 11 | list.copy() 复制列表 |
6、Tuple(元祖)
元组(tuple)与列表类似,元组中的元素类型也可以不相同,不同之处在于元组的元素不能修改
元组与字符串类似,可以被索引且下标从 0 开始,-1 为从末尾开始的位置,也可以进行截取。其实,可以把字符串看作一种特殊的元组
(1)基础用法
构造包含 0 个或 1 个元素的元组比较特殊,有一些额外的语法规则:
tup1 = ()      # 空元组
tup2 = (20,)   # 一个元素,需要在元素后添加逗号

not_a_tuple = (42)  # 这是整数 42,不是元组
(2)连接组合
元组中的元素值是不允许修改的,但我们可以对元组进行连接组合
tup1 = (12, 34.56)
tup2 = ('abc', 'xyz')

# 创建一个新的元组
tup3 = tup1 + tup2
print (tup3)
# (12, 34.56, 'abc', 'xyz')
(3)删除整个元组
元组中的元素值是不允许删除的,但我们可以使用del语句来删除整个元组
tup = ('1', '2', 3, 4)
del tup
(4)元组运算符
| Python 表达式 | 结果 | 描述 |
|---|---|---|
len((1, 2, 3)) | 3 | 计算元素个数 |
(1, 2, 3) + (4, 5, 6) | (1, 2, 3, 4, 5, 6) | 连接,c 就是一个新的元组,它包含了 a 和 b 中的所有元素。 |
(1, 2, 3) += (4, 5, 6) | (1, 2, 3, 4, 5, 6) | 连接,a 就变成了一个新的元组,它包含了 a 和 b 中的所有元素。 |
('Hi!',) * 4 | (‘Hi!’, ‘Hi!’, ‘Hi!’, ‘Hi!’) | 复制 |
3 in (1, 2, 3) | True | 元素是否存在 |
for x in (1, 2, 3): ... | 1 2 3 | 迭代 |
(5)元组内置函数
| 序号 | 方法及描述 |
|---|---|
| 1 | len(tuple) 计算元组元素个数 |
| 2 | max(tuple) 返回元组中元素最大值 |
| 3 | min(tuple) 返回元组中元素最小值 |
| 4 | tuple(iterable) 将可迭代系列转换为元组 |
(6)关于元组的不可变
所谓元组的不可变指的是元组所指向的内存中的内容不可变
tup = ('r', 'u', 'n', 'o', 'o', 'b')
# 不支持修改元素:tup[0] = 'g'

print(id(tup))     # 查看内存地址
# 4440687904

tup = (1,2,3)      # 重新赋值的元组
print(id(tup))
# 4441088800       # 内存地址不一样了
从以上实例可以看出,重新赋值的元组 tup,绑定到新的对象了,不是修改了原来的对象
7、Set(集合)
Python 中的集合(Set)是一种无序、可变的数据类型,用于存储唯一的元素。集合中的元素不会重复,并且可以进行交集、并集、差集等常见的集合操作
在 Python 中,集合使用大括号 {} 表示,元素之间用逗号 , 分隔。也可以使用 set() 函数创建集合
**注意:**创建一个空集合必须用 set() 而不是 {},因为 {} *创建的是一个空字典
(1)添加元素
s.add(x)将元素 x 添加到集合 s 中,如果元素已存在,则不进行任何操作
还有一个方法,也可以添加元素,且参数可以是列表,元组,字典等,语法格式如下:
s.update(x)x 可以有多个,用逗号分开
(2)移除元素
s.remove(x)将元素 x 从集合 s 中移除,如果元素不存在,则会发生错误
此外还有一个方法也是移除集合中的元素,且如果元素不存在,不会发生错误。格式如下所示:
s.discard(x)我们也可以设置随机删除集合中的一个元素,语法格式如下:
thisset = set(("1", "2", "3", "4"))
x = thisset.pop()

print(x)
# 2
多次执行测试结果都不一样
set 集合的 pop 方法会对集合进行无序的排列,然后将这个无序排列集合的左面第一个元素进行删除
(3)计算集合元素个数
len(s)(4)清空集合
s.clear()(5)判断元素是否在集合中存在
x in s(6)集合内置方法完整列表
| 方法 | 描述 |
|---|---|
| add() | 为集合添加元素 |
| clear() | 移除集合中的所有元素 |
| copy() | 拷贝一个集合 |
| difference() | 返回多个集合的差集 |
| difference_update() | 移除集合中的元素,该元素在指定的集合也存在 |
| discard() | 删除集合中指定的元素 |
| intersection() | 返回集合的交集 |
| intersection_update() | 返回集合的交集 |
| isdisjoint() | 判断两个集合是否包含相同的元素,如果没有返回 True,否则返回 False |
| issubset() | 判断指定集合是否为该方法参数集合的子集 |
| issuperset() | 判断该方法的参数集合是否为指定集合的子集 |
| pop() | 随机移除元素 |
| remove() | 移除指定元素 |
| symmetric_difference() | 返回两个集合中不重复的元素集合 |
| symmetric_difference_update() | 移除当前集合中在另外一个指定集合相同的元素,并将另外一个指定集合中不同的元素插入到当前集合中 |
| union() | 返回两个集合的并集 |
| update() | 给集合添加元素 |
| len() | 计算集合元素个数 |
8、Dictionary(字典)
字典是一种映射类型,用 {} 标识,它是一个 键(key) : 值(value) 的集合。键(key) 必须使用不可变类型,且在同一个字典中键必须是唯一的
字典是另一种可变容器模型,且可存储任意类型对象
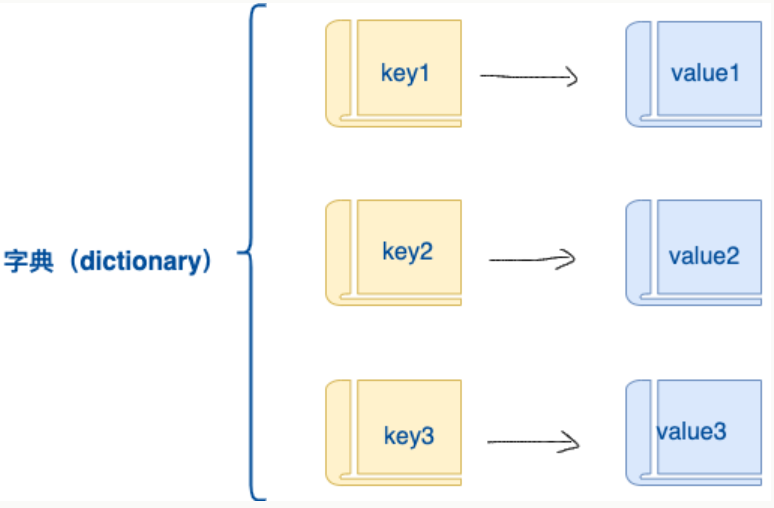
注意:Python 3.7 起,字典会保持元素的插入顺序,不再是无序的。如果需要有序字典的特性,直接使用普通dict 即可
dict1 = dict([('Runoob', 1), ('Google', 2), ('Taobao', 3)])
print(dict1)
# {'Runoob': 1, 'Google': 2, 'Taobao': 3}

# 使用的是字典推导式
dict2 = {x: x**2 for x in (2, 4, 6)}
print(dict2)
# {2: 4, 4: 16, 6: 36}

emptyDict = {}
print(emptyDict)
# {}
(1)访问字典里的值
tinydict = {'Name': 'Harper', 'Age': 23, 'Class': 'First'}

tinydict['Name']
(2)修改字典
tinydict['Age'] = 8 (3)删除字典元素
能删单一的元素也能清空字典
显式删除一个字典用del命令
del tinydict['Class'] # 删除键 'Name'
tinydict.clear()     # 清空字典
del tinydict         # 删除字典
(4)字典键的特性
字典值可以是任何的 python 对象,既可以是标准的对象,也可以是用户定义的,但键不行
两个重要的点需要记住:
1)不允许同一个键出现两次。创建时如果同一个键被赋值两次,后一个值会被记住,如下实例:
tinydict = {'Name': 'human', 'Age': 23, 'Name': 'Harper'}
print(tinydict)
# {'Name': 'Harper', 'Age': 23}
2)键必须不可变,所以可以用数字,字符串或元组充当,而用列表就不行,如下实例:
tinydict = {['Name']: 'Runoob', 'Age': 7} # 错误示例(5)字典内置函数&方法
内置函数:
| 序号 | 函数及描述 |
|---|---|
| 1 | len(dict) 计算字典元素个数,即键的总数 |
| 2 | str(dict) 输出字典,可以打印的字符串表示 |
| 3 | type(variable) 返回输入的变量类型,如果变量是字典就返回字典类型 |
内置方法:
| 序号 | 函数及描述 |
|---|---|
| 1 | dict.clear() 删除字典内所有元素 |
| 2 | dict.copy() 返回一个字典的浅复制 |
| 3 | dict.fromkeys() 创建一个新字典,以序列seq中元素做字典的键,val为字典所有键对应的初始值 |
| 4 | dict.get(key, default=None) 返回指定键的值,如果键不在字典中返回 default 设置的默认值 |
| 5 | key in dict 如果键在字典dict里返回true,否则返回false |
| 6 | dict.items() 以列表返回一个视图对象 |
| 7 | dict.keys() 返回一个视图对象 |
| 8 | dict.setdefault(key, default=None) 和get()类似, 但如果键不存在于字典中,将会添加键并将值设为default |
| 9 | dict.update(dict2) 把字典dict2的键/值对更新到dict里 |
| 10 | dict.values() 返回一个视图对象 |
| 11 | dict.pop(key,default) 删除字典 key(键)所对应的值,返回被删除的值 |
| 12 | dict.popitem() 返回并删除字典中的最后一对键和值 |
9、Bytes 类型(二进制序列)
bytes 类型表示的是不可变的二进制序列(byte sequence)。与字符串类型不同的是,bytes 类型中的元素是整数值(0 到 255 之间的整数),而不是 Unicode 字符
bytes 类型通常用于处理二进制数据,比如图像文件、音频文件、视频文件等。在网络编程中,也经常使用 bytes 类型来传输二进制数据。
创建 bytes 对象最常见的方式是使用 b 前缀:
x = b"hello"           # 使用 b 前缀创建 bytes 对象
print(x)               # b'hello'
print(type(x))         # <class 'bytes'>
print(x[0])            # 104('h' 的 ASCII 值,bytes 元素是整数)
也可以使用 bytes() 函数将其他类型的对象转换为 bytes 类型,第二个参数指定编码方式:
x = bytes("hello", encoding="utf-8")与字符串类型类似,bytes 类型也支持切片、拼接、查找、替换等操作。由于 bytes 类型是不可变的,修改操作需要创建一个新的 bytes 对象:
x = b"hello"
y = x[1:3]          # 切片操作,得到 b'el'
z = x + b"world"    # 拼接操作,得到 b'helloworld'
print(y)            # b'el'
print(z)            # b'helloworld'
需要注意的是,bytes 类型中的元素是整数值,因此在进行比较操作时需要使用相应的整数值。可以用 ord() 函数将字符转换为对应的整数值:
x = b"hello"
if x[0] == ord("h"):    # ord("h") 返回 104
    print("第一个元素是 'h'")
四、数据类型转换
Python 数据类型转换可以分为两种:
- 隐式类型转换 - 自动完成
- 显式类型转换 - 需要使用类型函数来转换
1、隐式类型转换
在隐式类型转换中,Python 会自动将一种数据类型转换为另一种数据类型,不需要我们去干预
以下实例中,我们对两种不同类型的数据进行运算,较低数据类型(整数)就会转换为较高数据类型(浮点数)以避免数据丢失
num_int = 123
num_flo = 1.23
num_new = num_int + num_flo

print(type(num_int))
# <class 'int'>
print(type(num_int))
# <class 'float'>
print(type(num_int))
# <class 'float'>
2、显式类型转换
以下内置的函数可以执行数据类型之间的转换,这些函数返回一个新的对象,表示转换的值:
| 函数 | 描述 |
|---|---|
| int(x [,base]) | 将x转换为一个整数 |
| float(x) | 将x转换到一个浮点数 |
| complex(real [,imag]) | 创建一个复数 |
| str(x) | 将对象 x 转换为字符串 |
| repr(x) | 将对象 x 转换为表达式字符串 |
| eval(str) | 用来计算在字符串中的有效Python表达式,并返回一个对象 |
| tuple(s) | 将序列 s 转换为一个元组 |
| list(s) | 将序列 s 转换为一个列表 |
| set(s) | 转换为可变集合 |
| dict(d) | 创建一个字典。d 必须是一个 (key, value)元组序列。 |
| frozenset(s) | 转换为不可变集合 |
| chr(x) | 将一个整数转换为一个字符 |
| ord(x) | 将一个字符转换为它的整数值 |
| hex(x) | 将一个整数转换为一个十六进制字符串 |
| oct(x) | 将一个整数转换为一个八进制字符串 |
| bool(x) | 将对象 x 转换为布尔值(True 或 False) |
| bytes([source[, encoding[, errors]]]) | 将对象转换为不可变字节序列 |
| bytearray([source[, encoding[, errors]]]) | 将对象转换为可变字节数组 |
| memoryview(obj) | 返回给定参数的内存视图对象(不复制数据) |
| bin(x) | 将一个整数转换为一个二进制字符串 |
| ascii(x) | 返回对象的 ASCII 表示,非 ASCII 字符会被转义 |
五、Docstring 文档字符串
Python 的 Docstring(文档字符串)是一种特殊的注释,用于为函数、类、模块等添加文档说明。它类似于 Java 的 Javadoc,但更加强大和灵活
与普通注释不同,Docstring 可以通过 __doc__ 属性直接访问,也可以使用 help() 函数查看
1、基本语法
Docstring 使用三个双引号 """ 或三个单引号 ''' 包围,放在函数、类、模块的开头
def add(a, b):
    """返回两数之和"""
    return a + b

# 通过 __doc__ 属性访问
print(add.__doc__)
# 返回两数之和
2、使用 help() 查看文档
def add(a, b):
    """返回两数之和"""
    return a + b

# 使用 help() 函数
help(add)
"""
Help on function add in module __main__:

add(a, b)
    返回两数之和
"""
3、使用 inspect 模块提取文档
Python 的标准库提供了 inspect 模块,可以直接提取文档内容:
import inspect

def add(a, b):
    """返回两数之和"""
    return a + b

# 使用 inspect.getdoc() 获取文档
print(inspect.getdoc(add))
# 返回两数之和
4、多行 Docstring
对于复杂的函数,可以使用多行 Docstring:
def calculate(a, b, operation="add"):
    """
    执行数学运算

    参数:
        a: 第一个数字
        b: 第二个数字
        operation: 操作类型,可选 "add", "subtract", "multiply"

    返回:
        计算结果
    """
    pass
5、类的 Docstring
class Person:
    """人物类,用于表示一个人的基本信息"""

    def __init__(self, name, age):
        """
        初始化人物对象

        参数:
            name: 姓名
            age: 年龄
        """
        self.name = name
        self.age = age

    def introduce(self):
        """介绍这个人"""
        return f"我叫{self.name},今年{self.age}岁"

# 访问类的文档
print(Person.__doc__)

# 访问方法的文档
print(Person.introduce.__doc__)
6、Docstring 规范
Python 中有多种 Docstring 风格,常用的有:
- Google 风格:使用空格缩进,参数和返回值有明确的标签
- Sphinx/reST 风格:使用冒号开头,如
:param name: - NumPy 风格:与 Google 风格类似,但格式略有不同
建议在项目中选择一种风格并保持一致
六、运算符
Python 语言支持以下类型的运算符:
- 算术运算符
- 比较(关系)运算符
- 赋值运算符
- 逻辑运算符
- 位运算符
- 成员运算符
- 身份运算符
1、算术运算符
| 运算符 | 描述 |
|---|---|
| + | 加 |
| - | 减 |
| * | 乘 |
| / | 除 |
| % | 取模 - 返回除法的余数 |
| ** | 幂 - 返回x的y次幂 |
| // | 取整除 - 往小的方向取整数 |
2、比较运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| == | 等于 | (a == b) 返回 False |
| != | 不等于 | (a != b) 返回 True |
| > | 大于 | (a > b) 返回 False |
| < | 小于 | (a < b) 返回 True |
| >= | 大于等于 | (a >= b) 返回 False |
| <= | 小于等于 | (a <= b) 返回 True |
3、赋值运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| = | 简单的赋值运算符 | c = a + b 将 a + b 的运算结果赋值为 c |
| += | 加法赋值运算符 | c += a 等效于 c = c + a |
| -= | 减法赋值运算符 | c -= a 等效于 c = c - a |
| *= | 乘法赋值运算符 | c *= a 等效于 c = c * a |
| /= | 除法赋值运算符 | c /= a 等效于 c = c / a |
| %= | 取模赋值运算符 | c %= a 等效于 c = c % a |
| **= | 幂赋值运算符 | c ** = a 等效于 c = c ** a |
| //= | 取整除赋值运算符 | c //= a 等效于 c = c // a |
| := | 海象运算符 |
海象运算符(Walrus Operator)的主要目的是在表达式中同时进行赋值和返回赋值的值,是Python3.8 版本新增运算符
使用海象运算符可以在一些情况下简化代码,尤其是在需要在表达式中使用赋值结果的情况下。这对于简化循环条件或表达式中的重复计算很有用
# 传统写法
n = 10
if n > 5:
    print(n)

# 使用海象运算符
if (n := 10) > 5:
    print(n)
海象运算符的优点:
- 海象运算符(
:=)允许在表达式内部进行赋值,这可以减少代码的重复,提高代码的可读性和简洁性 - 在上述例子中,传统写法需要单独一行来赋值
n,然后在if语句中进行条件检查。而使用海象运算符的写法可以在if语句中直接进行赋值和条件检查
4、位运算符
按位运算符是把数字看作二进制来进行计算的
Python中的按位运算法则如下:
下表中变量 a 为 60,b 为 13二进制格式如下:
a = 0011 1100

b = 0000 1101

-----------------
a&b = 0000 1100

a|b = 0011 1101

a^b = 0011 0001

~a = 1100 0011| 运算符 | 描述 | 规则 | 用途 |
|---|---|---|---|
| & | 按位与运算符(AND) | 两个位都为 1,结果才是 1;否则 0 | 掩码、清零某些位 |
| | | 按位或运算符(OR) | 只要有一个是 1,结果就是 1;都为 0 才是 0 | 置 1 某些位 |
| ^ | 按位异或(XOR) | 两位不一样则为 1,相同则为 0 | 翻转特定位、交换两个数、判断两数是否相等 |
| ~ | 按位取反(NOT) | 0 变 1,1 变 0 | 取反操作、求补码、配合掩码使用 |
| << | 左移动运算符 | 各二进制位全部左移若干位,高位丢弃,低位补 0 | 乘以 2 的 n 次方(如 a << 1 相当于 a × 2) |
| >> | 右移动运算符 | 各二进制位全部右移若干位,低位丢弃;高位补符号位(算术右移)或补 0(逻辑右移) | 除以 2 的 n 次方(如 a >> 1 相当于 a ÷ 2) |
5、逻辑运算符
| 运算符 | 逻辑表达式 | 描述 |
|---|---|---|
| and | x and y | 布尔”与” |
| or | x or y | 布尔”或” |
| not | not x | 布尔”非” |
6、成员运算符
| 运算符 | 描述 |
|---|---|
| in | 如果在指定的序列中找到值返回 True,否则返回 False |
| not in | 如果在指定的序列中没有找到值返回 True,否则返回 False |
a = 10
list = [1, 2, 3, 4, 5 ]

if ( a in list ):
   print ("变量 a 在给定的列表中 list 中")
else:
   print ("变量 a 不在给定的列表中 list 中")
7、身份运算符
| 运算符 | 描述 |
|---|---|
| is | is 是判断两个标识符是不是引用自一个对象 |
| is not | is not 是判断两个标识符是不是引用自不同对象 |
注: id() 函数用于获取对象内存地址
a = 20
b = 20

if ( a is b ):
   print ("1 - a 和 b 有相同的标识")
else:
   print ("1 - a 和 b 没有相同的标识")
# 1 - a 和 b 有相同的标识

if ( id(a) == id(b) ):
   print ("2 - a 和 b 有相同的标识")
else:
   print ("2 - a 和 b 没有相同的标识")
 # 2 - a 和 b 有相同的标识
is 与 == 区别:
is 用于判断两个变量引用对象是否为同一个, == 用于判断引用变量的值是否相等
a = [1, 2, 3]
b = a
print(b is a )
# True
print(b == a)
# True

b = a[:]
print(b is a)
# False
print(b == a)
# True
8、运算符优先级
以下表格列出了从最高到最低优先级的所有运算符, 相同单元格内的运算符具有相同优先级。 运算符均指二元运算,除非特别指出。 相同单元格内的运算符从左至右分组(除了幂运算是从右至左分组):
| 运算符 | 描述 |
|---|---|
(expressions...),[expressions...], {key: value...}, {expressions...} | 圆括号的表达式 |
x[index], x[index:index], x(arguments...), x.attribute | 读取,切片,调用,属性引用 |
| await x | await 表达式 |
** | 乘方(指数) |
+x, -x, ~x | 正,负,按位非 NOT |
*, @, /, //, % | 乘,矩阵乘,除,整除,取余 |
+, - | 加和减 |
<<, >> | 移位 |
& | 按位与 AND |
^ | 按位异或 XOR |
| ` | ` |
in,not in, is,is not, <, <=, >, >=, !=, == | 比较运算,包括成员检测和标识号检测 |
not x | 逻辑非 NOT |
and | 逻辑与 AND |
or | 逻辑或 OR |
if -- else | 条件表达式 |
lambda | lambda 表达式 |
:= | 赋值表达式 |
注意:Python3 已不支持 <> 运算符,可以使用 != 代替,如果你一定要使用这种比较运算符,可以使用以下的方式:
from __future__ import barry_as_FLUFL
print(1 <> 2)
# True
七、Python 流程控制语句
由于本文为 Python 高级教程,本章对于基础语法的使用忽略
1、条件控制
| 关键字 / 函数 | 说明 | 示例 |
|---|---|---|
if | 条件判断语句,当条件为 True 时执行代码块 | if x > 0: |
elif | 多条件判断分支(else if) | elif x == 0: |
else | 所有条件不满足时执行 | else: |
pass | 空语句,占位用,保证语法完整 | if x > 0: pass |
match | 结构化模式匹配(Python 3.10+,类似 switch) | match x: case 1: ... |
Python 3.10 增加了 match…case 的条件判断,不需要再使用一连串的 if-else 来判断了
match 后的对象会依次与 case 后的内容进行匹配,如果匹配成功,则执行匹配到的表达式,否则直接跳过,_ 可以匹配一切
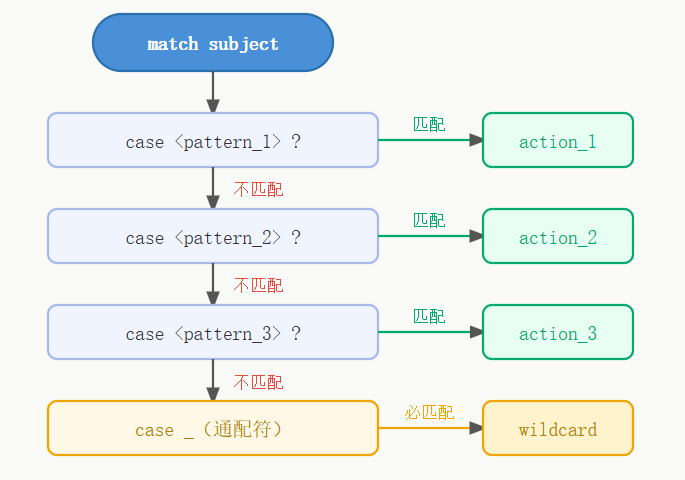
def http_error(status):
    match status:
        case 400:
            return "Bad request"
        case 404:
            return "Not found"
        case 418:
            return "I'm a teapot"
        case _:
            return "Something's wrong with the internet"

print(http_error(400))
print(http_error(404))
print(http_error(418))
print(http_error(500))
一个 case 也可以设置多个匹配条件,条件使用 | 隔开
...
    case 401|403|404:
        return "Not allowed"
2、循环语句
| 关键字 / 函数 | 说明 | 示例 |
|---|---|---|
for | 迭代循环,用于遍历序列或可迭代对象 | for i in list: |
while | 条件循环,条件为 True 时持续执行 | while x > 0: |
break | 立即终止当前循环 | break |
continue | 跳过本次循环剩余代码,进入下一次迭代 | continue |
else(循环) | 循环正常结束(未被 break)时执行 | for i in range(3): ... else: ... |
pass | 循环中的占位语句(空操作) | for i in range(5): pass |
range() | 生成整数序列,常与 for 循环配合使用 | range(0, 5) |
enumerate() | 遍历时同时获取索引和值 | for i, v in enumerate(list): |
(1)while 循环
while 判断条件(condition):
    执行语句(statements)……
(2)for 循环
for <variable> in <sequence>:
    <statements>
else:
    <statements>
for…else
for item in iterable:
    # 循环主体
else:
    # 循环结束后执行的代码
5、推导式
Python 推导式是一种独特的数据处理方式,可以从一个数据序列构建另一个新的数据序列的结构体
Python 推导式是一种强大且简洁的语法,适用于生成列表、字典、集合和生成器
在使用推导式时,需要注意可读性,尽量保持表达式简洁,以免影响代码的可读性和可维护性
Python 支持各种数据结构的推导式:
- 列表(list)推导式
- 字典(dict)推导式
- 集合(set)推导式
- 元组(tuple)推导式
(1)列表推导式
[表达式 for 变量 in 列表]
[out_exp_res for out_exp in input_list]

或者

[表达式 for 变量 in 列表 if 条件]
[out_exp_res for out_exp in input_list if condition]- out_exp_res:列表生成元素表达式,可以是有返回值的函数
- for out_exp in input_list:迭代 input_list 将 out_exp 传入到 out_exp_res 表达式中
- if condition:条件语句,可以过滤列表中不符合条件的值
multiples = [i for i in range(30) if i % 3 == 0]
print(multiples)
# [0, 3, 6, 9, 12, 15, 18, 21, 24, 27]
(2)字典推导式
{ key_expr: value_expr for value in collection }

或

{ key_expr: value_expr for value in collection if condition }
listdemo = ['Google','Runoob', 'Taobao']
# 将列表中各字符串值为键,各字符串的长度为值,组成键值对
newdict = {key:len(key) for key in listdemo}
print(newdict)
# {'Google': 6, 'Runoob': 6, 'Taobao': 6}(3)集合推导式
{ expression for item in Sequence }
或
{ expression for item in Sequence if conditional }
setnew = {i**2 for i in (1,2,3)}
print(setnew)
# {1, 4, 9}(4)元组推导式(生成器表达式)
元组推导式可以利用 range 区间、元组、列表、字典和集合等数据类型,快速生成一个满足指定需求的元组
(expression for item in Sequence )
或
(expression for item in Sequence if conditional )
元组推导式返回的结果是一个生成器对象
a = (x for x in range(1,10))
print(a)
print(type(a))
# <generator object <genexpr> at 0x0000019C689B5A80>
# <class 'generator'>

# 使用 tuple() 函数,可以直接将生成器对象转换成元组
print(tuple(a))
print(type(tuple(a)))
# (1, 2, 3, 4, 5, 6, 7, 8, 9)
<class 'tuple'>
6、迭代器与生成器
(1)迭代器
迭代是 Python 最强大的功能之一,是访问集合元素的一种方式。迭代器是一个可以记住遍历的位置的对象,迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束。迭代器只能往前不会后退。
迭代器有两个基本的方法:iter() 和 next(),字符串,列表或元组对象都可用于创建迭代器:
list=[1,2,3,4]
it = iter(list)    # 创建迭代器对象

print (next(it))   # 输出迭代器的下一个元素
# 1
print (next(it))
# 2
迭代器对象可以使用常规 for 语句进行遍历:
list=[1,2,3,4]
it = iter(list)

for x in it:
    print (x, end=" ")
# 1 2 3 4
也可以使用 next() 函数:
import sys

list=[1,2,3,4]
it = iter(list)

while True:
    try:
        print (next(it))
    except StopIteration:
        sys.exit()
(2)创建一个迭代器
把一个类作为一个迭代器使用需要在类中实现两个方法 iter() 与 next()
iter() 方法返回一个特殊的迭代器对象, 这个迭代器对象实现了 next() 方法并通过 StopIteration 异常标识迭代的完成,next() 方法会返回下一个迭代器对象
创建一个返回数字的迭代器,初始值为 1,逐步递增 1:
class MyNumbers:
  def __iter__(self):
    self.a = 1
    return self

  def __next__(self):
    x = self.a
    self.a += 1
    return x

myclass = MyNumbers()
myiter = iter(myclass)

print(next(myiter))
print(next(myiter))
print(next(myiter))
print(next(myiter))
print(next(myiter))

# 1
# 2
# 3
# 4
# 5
(3)StopIteration
StopIteration 异常用于标识迭代的完成,防止出现无限循环的情况,在 next() 方法中我们可以设置在完成指定循环次数后触发 StopIteration 异常来结束迭代
class MyNumbers:
  def __iter__(self):
    self.a = 1
    return self

  def __next__(self):
    if self.a <= 20:
      x = self.a
      self.a += 1
      return x
    else:
      raise StopIteration
(4)生成器
在 Python 中,使用了 yield 的函数被称为生成器(generator)
yield 是一个关键字,用于定义生成器函数,生成器函数是一种特殊的函数,可以在迭代过程中逐步产生值,而不是一次性返回所有结果
跟普通函数不同的是,生成器是一个返回迭代器的函数,只能用于迭代操作,更简单点理解生成器就是一个迭代器
当在生成器函数中使用 yield 语句时,函数的执行将会暂停,并将 yield 后面的表达式作为当前迭代的值返回,然后,每次调用生成器的 next() 方法或使用 for 循环进行迭代时,函数会从上次暂停的地方继续执行,直到再次遇到 yield 语句。这样,生成器函数可以逐步产生值,而不需要一次性计算并返回所有结果
调用一个生成器函数,返回的是一个迭代器对象
下面是一个简单的示例,展示了生成器函数的使用:
def countdown(n):
    while n > 0:
        yield n
        n -= 1

# 创建生成器对象
generator = countdown(5)

# 通过迭代生成器获取值
print(next(generator))  # 输出: 5
print(next(generator))  # 输出: 4
print(next(generator))  # 输出: 3

# 使用 for 循环迭代生成器
for value in generator:
    print(value)        # 输出: 2 1
以下实例使用 yield 实现斐波那契数列:
import sys

def fibonacci(n):     # 生成器函数 - 斐波那契
    a, b, counter = 0, 1, 0
    while True:
        if (counter > n):
            return
        yield a
        a, b = b, a + b
        counter += 1
f = fibonacci(10)     # f 是一个迭代器,由生成器返回生成

while True:
    try:
        print (next(f), end=" ")
    except StopIteration:
        sys.exit()
# 0 1 1 2 3 5 8 13 21 34 55
7、with
在 Python 编程中,资源管理是一个重要但容易被忽视的环节。with 关键字为我们提供了一种优雅的方式来处理文件操作、数据库连接等需要明确释放资源的场景
with 是 Python 中的一个关键字,用于上下文管理协议(Context Management Protocol)。它简化了资源管理代码,特别是那些需要明确释放或清理的资源(如文件、网络连接、数据库连接等)
(1)为什么需要 with 语句?
1)传统资源管理的问题
我们先看一个典型的文件操作示例:
file = open('example.txt', 'r')
try:
    content = file.read()
    # 处理文件内容
    ......
finally:
    file.close()
这种写法存在几个问题:
- 容易忘记关闭资源:如果没有
try-finally块,可能会忘记调用close() - 代码冗长:简单的文件操作需要多行代码
- 异常处理复杂:需要手动处理可能出现的异常
2)with 语句的优势
with 语句通过上下文管理协议(Context Management Protocol)解决了这些问题:
- 自动资源释放:确保资源在使用后被正确关闭
- 代码简洁:减少样板代码
- 异常安全:即使在代码块中发生异常,资源也会被正确释放
- 可读性强:明确标识资源的作用域
(2)with 语句的基本语法
with expression [as variable]:
# 代码块expression返回一个支持上下文管理协议的对象as variable是可选的,用于将表达式结果赋值给变量- 代码块执行完毕后,自动调用清理方法
最常见的 with 语句应用是文件操作:
with open('example.txt', 'r') as file:
    content = file.read()
    print(content)
# 文件已自动关闭
(3)with 语句的工作原理
1)上下文管理协议
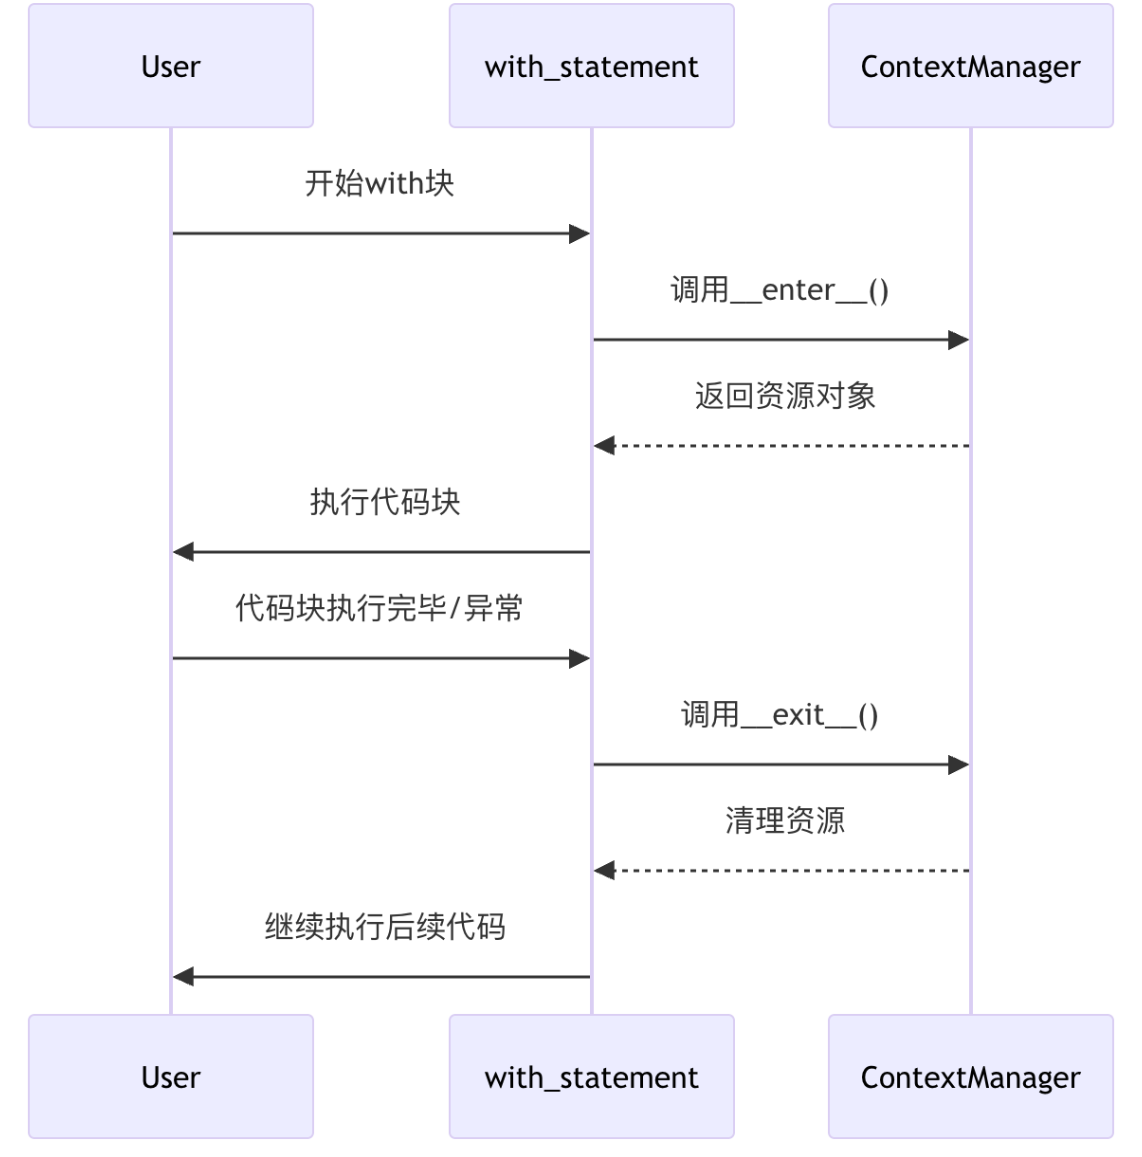
with 语句背后是 Python 的上下文管理协议,该协议要求对象实现两个方法:
__enter__():进入上下文时调用,返回值赋给as后的变量__exit__():退出上下文时调用,处理清理工作
2)执行流程
3)异常处理机制
__exit__() 方法接收三个参数:
exc_type:异常类型exc_val:异常值exc_tb:异常追踪信息
如果 __exit__() 返回 True,则表示异常已被处理,不会继续传播;返回 False 或 None,异常会继续向外传播
(4)实际应用场景
1)文件操作
# 同时打开多个文件
with open('input.txt', 'r') as infile, open('output.txt', 'w') as outfile:
    content = infile.read()
    outfile.write(content.upper())
2)数据库连接
import sqlite3

with sqlite3.connect('database.db') as conn:
    cursor = conn.cursor()
    cursor.execute('SELECT * FROM users')
    results = cursor.fetchall()
# 连接自动关闭
3)线程锁
import threading

lock = threading.Lock()

with lock:
    # 临界区代码
    print("这段代码是线程安全的")
4)临时修改系统状态
import decimal

with decimal.localcontext() as ctx:
    ctx.prec = 42  # 临时设置高精度
    # 执行高精度计算
# 精度恢复原设置
(5)创建自定义的上下文管理器
1)类实现方式
class FileManager(object):
    def __init__(self, name, mode):
        print("调用__init__方法")
        self.name = name
        self.mode = mode
        self.file = None

    def __enter__(self):
        print("调用__enter__方法")
        self.file = open(self.name, self.mode)
        return self.file

    def __exit__(self, exc_type, exc_val, exc_tb):
        print("调用__exit__方法")
        if self.file:
            self.file.close()

with FileManager("test.txt", "r") as f:
    print("准备读取文件")
    content = f.read()
2)使用 contextlib 模块
Python 的 contextlib 模块提供了更简单的方式来创建上下文管理器:
from contextlib import contextmanager

@contextmanager
def tag(name):
    print(f"<{name}>")
    yield
    print(f"</{name}>")

# 使用示例
with tag("h1"):
    print("这是一个标题")
(6)常见问题与最佳实践
1)常见错误
- 错误地认为 with 只能用于文件
- 忽略 __ exit __ 的返回值:忘记返回True/False可能导致异常处理不符合预期
2)最佳实践
- 优先使用 with 管理资源:对于文件、网络连接、锁等资源,总是优先考虑使用
with语句 - 保持上下文简洁:
with块中的代码应该只包含与资源相关的操作 - 合理处理异常:在自定义上下文管理器中,根据需求决定是否抑制异常
- 利用多个上下文:Python 允许在单个
with语句中管理多个资源
(7)总结要点
| 关键点 | 说明 |
|---|---|
| 自动资源管理 | with 语句确保资源被正确释放 |
| 上下文协议 | 需要实现 __enter__ 和 __exit__ 方法 |
| 异常安全 | 即使代码块中出现异常,资源也会被释放 |
| 常见应用 | 文件操作、数据库连接、线程锁等 |
| 自定义实现 | 可以通过类或 contextlib 创建自定义上下文管理器 |
with 语句是 Python 中一项强大的特性,它不仅能简化代码,还能提高程序的健壮性。掌握 with 语句的使用和原理,将帮助你写出更专业、更可靠的 Python 代码!
八、函数基础到进阶
由于本文为 Python 高级教程,基础语法使用忽略
当把函数名赋值给一个变量的时候,那这个变量就实现了和函数一样的功能
def test()
	print("hello world")

demo = test
demo()
# hello world
1、函数基础
(1)参数传递的可更改(mutable)与不可更改(immutable)对象
在 python 中,strings, tuples, 和 numbers 是不可更改的对象,而 list,dict 等则是可以修改的对象
- **不可变类型:**变量赋值 a=5 后再赋值 a=10,这里实际是新生成一个 int 值对象 10,再让 a 指向它,而 5 被丢弃,不是改变 a 的值,相当于新生成了 a
- **可变类型:**变量赋值 la=[1,2,3,4] 后再赋值 la[2]=5 则是将 list la 的第三个元素值更改,本身la没有动,只是其内部的一部分值被修改了
python 函数的参数传递:
- **不可变类型:**类似 C++ 的值传递,如整数、字符串、元组。如 fun(a),传递的只是 a 的值,没有影响 a 对象本身。如果在 fun(a) 内部修改 a 的值,则是新生成一个 a 的对象。
- **可变类型:**类似 C++ 的引用传递,如 列表,字典。如 fun(la),则是将 la 真正的传过去,修改后 fun 外部的 la 也会受影响
python 中一切都是对象,严格意义我们不能说值传递还是引用传递,我们应该说传不可变对象和传可变对象
1)python 传不可变对象实例
def change(a):
    print(id(a))   # 指向的是同一个对象
    a=10
    print(id(a))   # 一个新对象

a=1
print(id(a))
change(a)
print(id(a))
#140705553871784
#140705553871784
#140705553872072
#140705553871784
2)传可变对象实例
# 可写函数说明
def changeme( mylist ):
   "修改传入的列表"
   mylist.append([1,2,3,4])
   print ("函数内取值: ", mylist)
   return

# 调用changeme函数
mylist = [10,20,30]
changeme( mylist )
print ("函数外取值: ", mylist)
#函数内取值:  [10, 20, 30, [1, 2, 3, 4]]
#函数外取值:  [10, 20, 30, [1, 2, 3, 4]]
(2)参数类型
以下是调用函数时可使用的正式参数类型:
-
必需参数:以正确的顺序传入函数,调用时的数量必须和声明时的一样
print_str("hello world") -
关键字参数:允许函数调用时参数的顺序与声明时不一致
print_str(str = "hello world") -
默认参数:如果没有传递参数,则会使用默认参数
-
不定长参数:处理比当初声明时更多的参数
加了星号 ***** 的参数会以元组(tuple)的形式导入,存放所有未命名的变量参数,如果在函数调用时没有指定参数,它就是一个空元组:
def printinfo( arg1, *vartuple ):
   print ("输出: ")
   print (arg1)
   print (vartuple)

printinfo( 70, 60, 50 )
加了两个星号 ** 的参数会以字典的形式导入:
def printinfo( arg1, **vardict ):
   print ("输出: ")
   print (arg1)
   print (vardict)

printinfo(1, a=2,b=3)
声明函数时,参数中星号 ***** 可以单独出现,如果单独出现星号 *****,则星号 ***** 后的参数必须用关键字传入
def f(a,b,*,c):
    print(a+b+c)

# f(1,2,3)   # 报错
f(1,2,c=3) # 正常
# 6
(3)强制位置参数
Python3.8 新增了一个函数形参语法 / 用来指明函数形参必须使用指定位置参数,不能使用关键字参数的形式
在以下的例子中,形参 a 和 b 必须使用指定位置参数,c 或 d 可以是位置形参或关键字形参,而 e 和 f 要求为关键字形参:
def f(a, b, /, c, d, *, e, f):
    print(a, b, c, d, e, f)

# 以下使用方法是正确的:
f(10, 20, 30, d=40, e=50, f=60)

# 以下使用方法会发生错误:
f(10, b=20, c=30, d=40, e=50, f=60)   # b 不能使用关键字参数的形式
f(10, 20, 30, 40, 50, f=60)           # e 必须使用关键字参数的形式
2、lambda(匿名函数)
Python 使用 lambda 来创建匿名函数,所谓匿名,意即不再使用 def 语句这样标准的形式定义一个函数
lambda 函数是一种小型、匿名的、内联函数,它可以具有任意数量的参数,但只能有一个表达式
匿名函数不需要使用 def 关键字定义完整函数
lambda 函数通常用于编写简单的、单行的函数,通常在需要函数作为参数传递的情况下使用,例如在 map()、filter()、reduce() 等函数中。
lambda 函数特点:
- lambda 函数是匿名的,它们没有函数名称,只能通过赋值给变量或作为参数传递给其他函数来使用。
- lambda 函数通常只包含一行代码,这使得它们适用于编写简单的函数。
- lambda 只是一个表达式,函数体比 def 简单很多
- lambda 的主体是一个表达式,而不是一个代码块。仅仅能在 lambda 表达式中封装有限的逻辑进去
- lambda 函数拥有自己的命名空间,且不能访问自己参数列表之外或全局命名空间里的参数
- 虽然 lambda 函数看起来只能写一行,却不等同于 C 或 C++ 的内联函数,内联函数的目的是调用小函数时不占用栈内存从而减少函数调用的开销,提高代码的执行速度
lambda 语法格式:
lambda arguments: expressionarguments是参数列表,可以包含零个或多个参数,但必须在冒号(:)前指定expression是一个表达式,用于计算并返回函数的结果
实例:
sum = lambda arg1, arg2: arg1 + arg2
print ("相加后的值为 : ", sum( 10, 20 ))
以下的 lambda 函数没有参数:
f = lambda: "Hello, world!"
print(f())
# Hello, world!
我们可以将匿名函数封装在一个函数内,这样可以使用同样的代码来创建多个匿名函数
3、装饰器
装饰器(decorator)是 Python 中的一种高级功能,用于在不修改原函数代码的前提下,动态扩展函数或类的功能
本质上,装饰器是一个函数:它接收一个函数作为参数,并返回一个新的函数(通常是对原函数的增强版本)
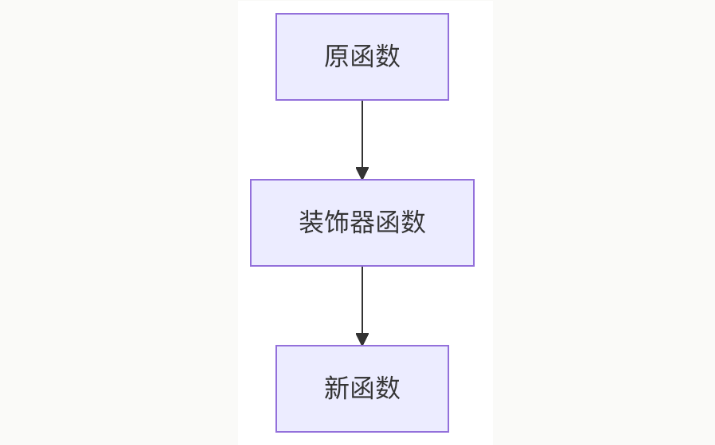
装饰器通过 @decorator_name 语法应用在函数或方法定义之前
Python 还提供了一些内置装饰器,例如 @staticmethod 和 @classmethod
常见应用场景:
- 日志记录:记录函数调用信息、参数和返回值
- 性能统计:统计函数执行时间
- 权限控制:限制函数访问权限
- 缓存:缓存函数结果,提高性能
(1)基础用法
1)基本语法
装饰器的核心思想是:用一个函数“包装”另一个函数
def decorator_function(original_function):
    def wrapper(*args, **kwargs):
        # 调用前
        print("执行前")

        result = original_function(*args, **kwargs)

        # 调用后
        print("执行后")

        return result
    return wrapper

# 语法糖写法
@decorator_function
def target_function():
    print("原函数执行")
target_function()
# 执行前
# 原函数执行
# 执行后decorator_function:装饰器函数(接收原函数)wrapper:包装函数(真正被执行)@decorator_function:等价于函数替换
等价写法:
target_function = decorator_function(target_function)2)带参数的装饰器
如果原函数有参数,需要在 wrapper 中使用 *args, **kwargs:
def my_decorator(func):
    def wrapper(*args, **kwargs):
        print("执行前")
        func(*args, **kwargs)
        print("执行后")
    return wrapper

@my_decorator
def greet(name):
    print(f"Hello, {name}!")

greet("Alice")
3)带参数的装饰器(进阶)
def repeat(num_times):
    def decorator(func):
        def wrapper(*args, **kwargs):
            for _ in range(num_times):
                func(*args, **kwargs)
        return wrapper
    return decorator

@repeat(3)
def say_hello():
    print("Hello!")

say_hello()
# Hello!
# Hello!
# Hello!
**说明:**repeat 是”装饰器工厂”函数,外层函数用于接收参数
等价于:
decorator = repeat(3)
say_hello = decorator(say_hello)
say_hello()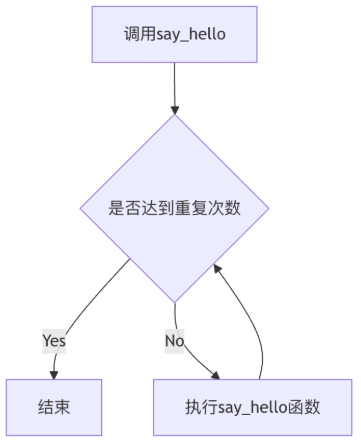
(2)类装饰器
除了函数,装饰器也可以作用于类,类装饰器接收一个类,并返回修改后的类或包装类
- 增强类方法
- 控制实例化过程
- 实现单例、日志等功能
1)函数形式的类装饰器
def log_class(cls):
    class Wrapper:
        def __init__(self, *args, **kwargs):
            self.wrapped = cls(*args, **kwargs)

        def __getattr__(self, name):
            return getattr(self.wrapped, name)

        def display(self):
            print("调用前")
            self.wrapped.display()
            print("调用后")

    return Wrapper

@log_class
class MyClass:
    def display(self):
        print("原方法")

obj = MyClass()
obj.display()
# 调用前
# 原方法
# 调用后
2)类形式的类装饰器
class SingletonDecorator:
    def __init__(self, cls):
        self.cls = cls
        self.instance = None

    # db1 = Database() 时自动触发
    def __call__(self, *args, **kwargs):
        if self.instance is None:
            self.instance = self.cls(*args, **kwargs)
        return self.instance

@SingletonDecorator
class Database:
    def __init__(self):
        print("初始化")

db1 = Database()
db2 = Database()
print(db1 is db2)
# 初始化
# True
(3)内置装饰器
常用内置装饰器:
- @staticmethod:定义静态方法
- @classmethod:定义类方法
- @property:将方法变为属性
- @name.setter:配合 @property,给伪装出来的属性支持赋值操作
class MyClass:
    @staticmethod
    def static_method():
        print("静态方法")

    @classmethod
    def class_method(cls):
        print(cls.__name__)

    @property
    def name(self):
        return self._name

    @name.setter
    def name(self, value):
        self._name = value
(4)多个装饰器的堆叠
多个装饰器在定义阶段从下到上依次包裹函数,调用阶段从上到下依次执行:
def decorator1(func):
    def wrapper():
        print("Decorator 1")
        func()
    return wrapper

def decorator2(func):
    def wrapper():
        print("Decorator 2")
        func()
    return wrapper

@decorator1
@decorator2
def say_hello():
    print("Hello!")

say_hello()
# Decorator 1
# Decorator 2
# Hello!
(5)核心总结
装饰器 = 函数包装函数 + 不修改原代码扩展功能- @ 语法本质是函数替换
- wrapper 才是真正执行的函数
- 推荐使用 *args, **kwargs 提高通用性
- 支持函数、类、甚至带参数的装饰器
4、高阶函数
(1)定义
在 Python 中,函数也是一种对象,可以像普通变量一样被传递。如果一个函数满足以下任意一个条件,我们就称它为高阶函数:
- 接收一个或多个函数作为参数
- 将函数作为返回值返回
(2)Python 内置的高阶函数
Python 本身提供了很多内置的高阶函数,最常用的有 map()、filter()、reduce() 和 sorted()
map(func, iterable):对可迭代对象中的每一个元素依次执行 func,返回迭代器
nums = [1, 2, 3, 4, 5]

# 把每个元素平方
result = map(lambda x: x ** 2, nums)
print(list(result))
# [1, 4, 9, 16, 25]
filter(func, iterable):保留 func 返回值为 True 的元素
nums = [1, 2, 3, 4, 5, 6]

# 只保留偶数
result = filter(lambda x: x % 2 == 0, nums)
print(list(result))
# [2, 4, 6]
reduce(func, iterable):对元素逐个归约,需要从 functools 导入
from functools import reduce

nums = [1, 2, 3, 4]

# 累加求和:((1+2)+3)+4
result = reduce(lambda x, y: x + y, nums)
print(result)
# 10
sorted(iterable, key=func):通过 key 指定排序规则,key 接收的就是一个函数
users = [("Tom", 18), ("Jerry", 22), ("Alice", 16)]

# 按年龄排序
result = sorted(users, key=lambda u: u[1])
print(result)
# [('Alice', 16), ('Tom', 18), ('Jerry', 22)]注意:map、filter 返回的是迭代器,用 list() 转成列表才能看到全部结果;迭代器用过一次就会耗尽
5、回调函数
回调函数:把一个函数(a)作为一个参数传递到另一个函数(b)中去,那么这个函数(a)我们就叫做回调函数
def add(x, y):
    print(x + y)

def sub(a, b):
    print(a - b)

def mul(x, y):
    print(x * y)

def div(x, y):
    print(x / y)

# 需求: 封装一个万能函数,传入两个参数,直接实现加减乘除的操作
def demo(x, y, func):
    func(x, y)

demo(2, 1, add)
demo(2, 1, sub)
demo(2, 1, mul)
demo(2, 1, div)注意:这里传的是 add,而不是 add()
add表示函数本身,是把函数 “交出去”add()表示立刻执行函数并拿到返回值。 我们要的是把函数交给demo,让demo在内部决定什么时候调用它,所以不能加括号
回调函数在实际开发中非常常见,比如:
- 异步请求完成后执行的处理函数
- 事件触发时执行的钩子函数(按钮点击、数据加载完成)
- 框架中传入的排序、过滤、校验函数
它的核心思想是:把 “做什么” 和 “什么时候做” 解耦,外层函数负责流程控制,回调函数负责具体业务逻辑
6、闭包函数
(1)定义
如果一个函数里面嵌套了另一个函数,外部的函数叫做外函数,内部的函数叫内函数
如果在一个外部函数中定义了一个内部函数,并且外部函数的返回值是内部函数,就构成了一个闭包,则这个内部函数就被称为闭包
def outer():
    def inner():
        print('我是闭包函数')
    return inner      # 注意: 这里返回的是函数体,不是函数的调用

fn = outer()  		  # fn 等价于 inner 函数
fn() # 相当于调用了 inner 函数注意:return inner 不能写成 return inner()
(2)自由变量
内函数可以直接读取外函数作用域中的变量,这是闭包最核心的特性
def outer1(x):
    y = 11
    def inner1():    # 没有传入任何参数,内部函数可以使用外部函数的变量
        print(x + y)
    return inner1

fun1 = outer1(7)
fun1()
这里 inner1 中用到的 x 和 y,既不是局部变量,也不是全局变量,我们称之为自由变量—— 它们是在外函数作用域中定义、却被内函数 “捕获” 并长期持有的变量
可以通过 __code__.co_freevars 查看一个闭包捕获了哪些自由变量:
print(fun1.__code__.co_freevars)
# ('x', 'y')
(3)闭包会保存运行环境
按照一般的理解,outer1(7) 执行完之后,它的栈帧就应该被销毁,变量 x、y 也应该随之消失。但实际上 fun1() 还能正常打印 18,原因就是:闭包会把外函数的运行环境 “打包带走”
当 outer1 返回 inner1 时,Python 发现 inner1 引用了外函数的变量,就会把这部分变量保存下来,和函数对象绑定在一起。即使外函数已经执行完毕,这部分环境也不会释放,直到闭包对象本身被回收
fun2 = outer1(100)

fun2()
# 111
fun1()
# 18  —— fun1 的环境仍然保留,互不影响
(4)nonlocal 关键字
既然内函数能读取外函数的变量,那能不能直接修改呢?
def outer():
    num = 10
    def inner():
        num += 1      # 报错!UnboundLocalError
        print(num)
    return inner
直接运行会报错。这是因为 Python 看到 num += 1,会把 num 当作 inner 的局部变量,但 num 还没赋值就参与运算,所以报错
要在内函数中修改外函数的变量,必须使用 nonlocal 关键字声明:
def outer():
    num = 10
    def inner():
        nonlocal num   # 声明 num 不是局部变量,去外层找
        num += 1
        print(num)
    return inner

f = outer()
f()                # 11
f()                # 12
f()                # 13
加上 nonlocal 之后,每次调用 f() 都会在之前的基础上累加,这就是闭包 “记住状态” 的效果
注意:
nonlocal和global的区别:
global声明的是全局变量nonlocal声明的是最近一层外函数中的变量,而不是全局变量
(5)延迟绑定
这是闭包最容易踩的坑:
def create_funcs():
    funcs = []
    for i in range(3):
        def inner():
            print(i)
        funcs.append(inner)
    return funcs

fs = create_funcs()
fs[0]()             # 你以为是 0,实际是 2
fs[1]()             # 2
fs[2]() # 2-
for i in range(3)循环一共执行 3 次,每次定义一个函数对象
inner,放进列表。 -
所有
inner函数内部引用的变量i,不是当时 i 的值,而是同一个变量i(共享同一个变量地址) -
循环结束之后,
i的值变成了2(range (3) 最后一轮 i=2) -
后面调用
fs[0]()、fs[1]()、fs[2]()的时候,才去读取变量i,此时 i 早就等于 2 了
解决方案:在定义闭包的瞬间,把当前的值固定下来。利用默认参数:
def create_funcs():
    funcs = []
    for i in range(3):
        def inner(x=i):    # x=i 在定义时就把当前值固定下来
            print(x)
        funcs.append(inner)
    return funcs

fs = create_funcs()
fs[0]()             # 0
fs[1]()             # 1
fs[2]()             # 2
(6)闭包与装饰器的关系
现在回头看我们之前写的装饰器,就能明白它的底层原理了:
def decorator(func):
    def wrapper(*args, **kwargs):
        print('前置操作')
        result = func(*args, **kwargs)   # 捕获了外函数的 func
        print('后置操作')
        return result
return wrapper # 返回闭包decorator接收一个函数作为参数 → 这是高阶函数wrapper内层函数捕获了外函数的func,并被作为返回值 → 这是闭包
所以装饰器并不是什么魔法,它就是高阶函数和闭包的组合应用
7、高阶函数、回调函数、闭包函数的关系
| 概念 | 核心 |
|---|---|
| 高阶函数 | 接收函数作参数,或返回函数 |
| 回调函数 | 作为参数传入、在内部被调用的函数(高阶函数的一种使用场景) |
| 闭包 | 内层函数捕获并记住外层函数的变量环境 |
九、错误与异常
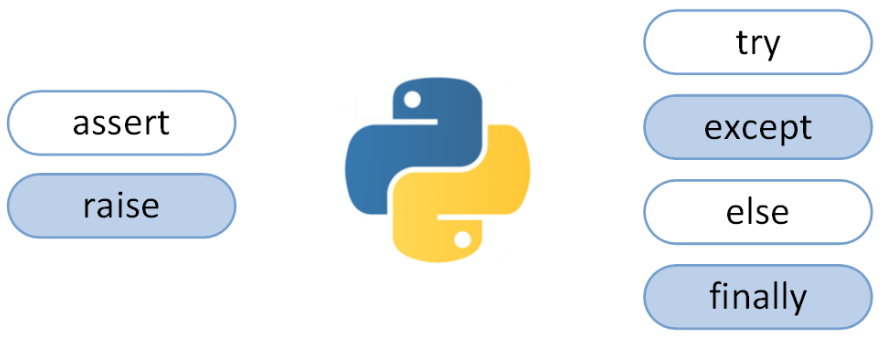
Python 有两种错误很容易辨认:语法错误和异常。本文会讲解异常相关知识点
Python assert(断言)用于判断一个表达式,在表达式条件为 false 的时候触发异常
1、异常
即便 Python 程序的语法是正确的,在运行它的时候,也有可能发生错误。运行期检测到的错误被称为异常
大多数的异常都不会被程序处理,都以错误信息的形式展现在这里:
>>> 10 * (1/0)             # 0 不能作为除数,触发异常
Traceback (most recent call last):
  File "<stdin>", line 1, in ?
ZeroDivisionError: division by zero

>>> 4 + spam*3             # spam 未定义,触发异常
Traceback (most recent call last):
  File "<stdin>", line 1, in ?
NameError: name 'spam' is not defined

>>> '2' + 2                # int 不能与 str 相加,触发异常
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: can only concatenate str (not "int") to str
异常以不同的类型出现,这些类型都作为信息的一部分打印出来:例子中的类型有 ZeroDivisionError,NameError 和 TypeError
错误信息的前面部分显示了异常发生的上下文,并以调用栈的形式显示具体信息
2、异常处理
(1)try/except 语句
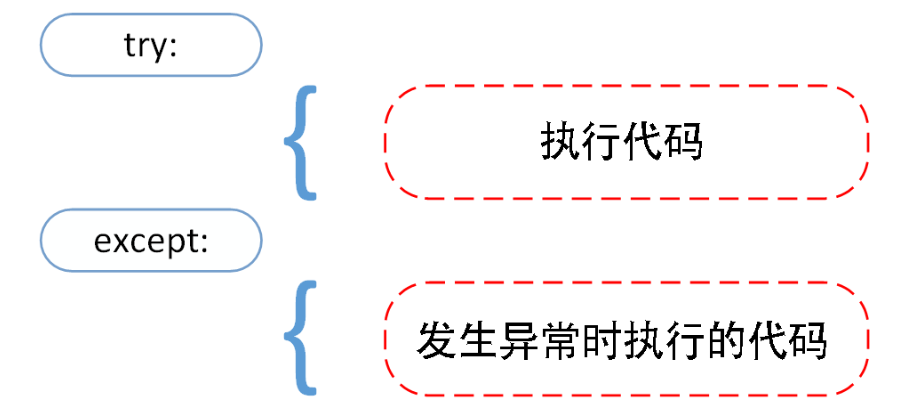
while True:
    try:
        x = int(input("请输入一个数字: "))
        break
    except ValueError:
        print("您输入的不是数字,请再次尝试输入!")
try 语句按照如下方式工作;
- 首先,执行 try 子句(在关键字 try 和关键字 except 之间的语句)
- 如果没有异常发生,忽略 except 子句,try 子句执行后结束
- 如果在执行 try 子句的过程中发生了异常,那么 try 子句余下的部分将被忽略。如果异常的类型和 except 之后的名称相符,那么对应的 except 子句将被执行
- 如果一个异常没有与任何的 except 匹配,那么这个异常将会传递给上层的 try 中
一个 try 语句可能包含多个except子句,分别来处理不同的特定的异常。最多只有一个分支会被执行。
处理程序将只针对对应的 try 子句中的异常进行处理,而不是其他的 try 的处理程序中的异常。
一个except子句可以同时处理多个异常,这些异常将被放在一个括号里成为一个元组,例如:
except (RuntimeError, TypeError, NameError):
    pass
最后一个 except 子句可以忽略异常的名称,它将被当作通配符使用。你可以使用这种方法打印一个错误信息,然后再次把异常抛出:
import sys

try:
    f = open('myfile.txt')
    s = f.readline()
    i = int(s.strip())
except OSError as err:
    print("OS error: {0}".format(err))
except ValueError:
    print("Could not convert data to an integer.")
except:     # 忽略异常的名称
    print("Unexpected error:", sys.exc_info()[0])
    raise
(2)try/except…else
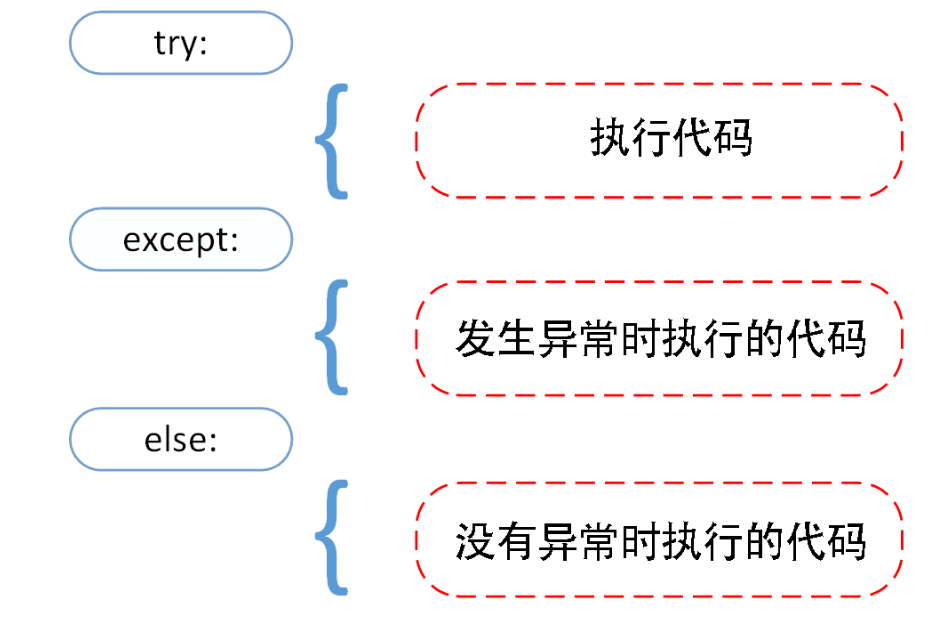
(3)try-finally 语句
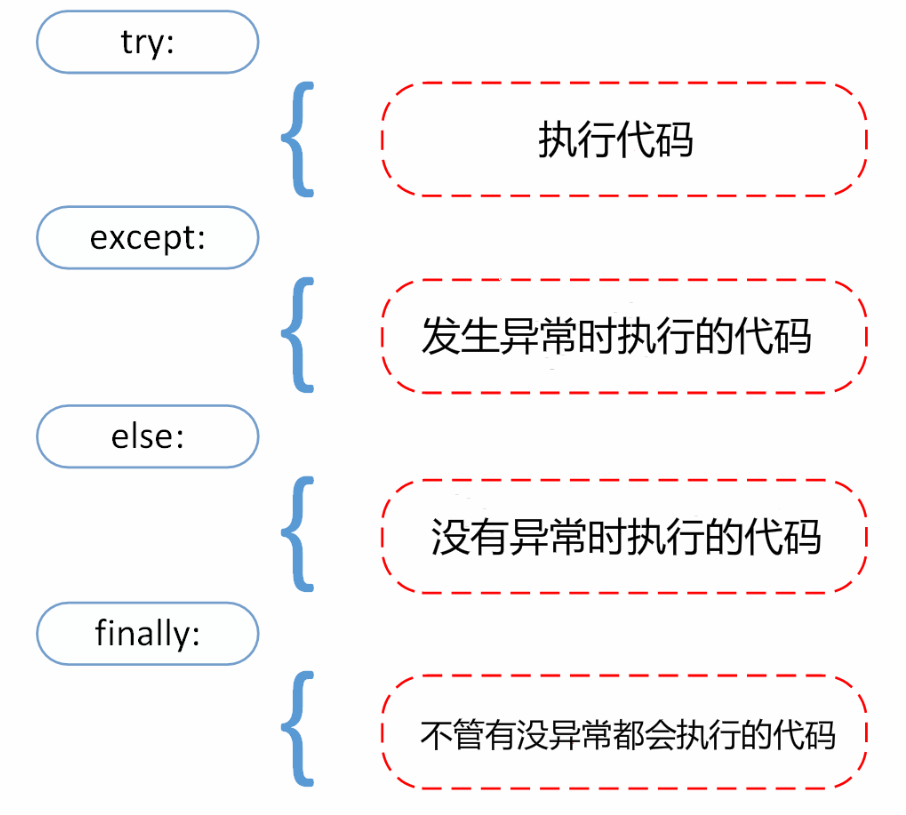
3、抛出异常
Python 使用 raise 语句抛出一个指定的异常
raise [Exception [, args [, traceback]]]x = 10
if x > 5:
raise Exception('x 不能大于 5。x 的值为: {}'.format(x))raise 唯一的一个参数指定了要被抛出的异常。它必须是一个异常的实例或者是异常的类(也就是 Exception 的子类)
如果你只想知道这是否抛出了一个异常,并不想去处理它,那么一个简单的 raise 语句就可以再次把它抛出
try:
    raise NameError('HiThere')   # 模拟一个异常
except NameError:
    print('An exception flew by!')
    raise
4、用户自定义异常
你可以通过创建一个新的异常类来拥有自己的异常。异常类继承自 Exception 类,可以直接继承,或者间接继承,例如:
class MyError(Exception):
    def __init__(self, value):
        self.value = value

    def __str__(self):
        return repr(self.value)

try:
    raise MyError(2 * 2)
except MyError as e:
    print('My exception occurred, value:', e.value)

raise MyError('oops!')
在这个例子中,类 Exception 默认的 init() 被覆盖
当创建一个模块有可能抛出多种不同的异常时,一种通常的做法是为这个包建立一个基础异常类,然后基于这个基础类为不同的错误情况创建不同的子类:
class Error(Exception):
    """Base class for exceptions in this module."""
    pass

class InputError(Error):
    """Exception raised for errors in the input.

    Attributes:
        expression -- input expression in which the error occurred
        message -- explanation of the error
    """

    def __init__(self, expression, message):
        self.expression = expression
        self.message = message

class TransitionError(Error):
    """Raised when an operation attempts a state transition that's not
    allowed.

    Attributes:
        previous -- state at beginning of transition
        next -- attempted new state
        message -- explanation of why the specific transition is not allowed
    """

    def __init__(self, previous, next, message):
        self.previous = previous
        self.next = next
        self.message = message
大多数的异常的名字都以”Error”结尾,就跟标准的异常命名一样
5、定义清理行为
try 语句还有另外一个可选的子句,它定义了无论在任何情况下都会执行的清理行为。 例如:
try:
    raise KeyboardInterrupt
finally:
    print('Goodbye, world!')
"""
Goodbye, world!
Traceback (most recent call last):
  File "...\test.py", line 2, in <module>
    raise KeyboardInterrupt
KeyboardInterrupt
"""
如果一个异常在 try 子句里(或者在 except 和 else 子句里)被抛出,而又没有任何的 except 把它截住,那么这个异常会在 finally 子句执行后被抛出,以下是一个更复杂的例子:
def divide(x, y):
    try:
        result = x / y
    except ZeroDivisionError:
        print("division by zero!")
    else:
        print("result is", result)
    finally:
        print("executing finally clause")

divide(2, 1)
"""
result is 2.0
executing finally clause
"""
divide(2, 0)
"""
division by zero!
executing finally clause
"""
divide("2", "1")
"""
executing finally clause
TypeError: unsupported operand type(s) for /: 'str' and 'str'
"""
5、预定义的清理行为
一些对象定义了标准的清理行为,无论系统是否成功的使用了它,一旦不需要它了,那么这个标准的清理行为就会执行
下面这个例子展示了尝试打开一个文件,然后把内容打印到屏幕上:
for line in open("myfile.txt"):
    print(line, end="")
以上这段代码的问题是,当执行完毕后,文件会保持打开状态,并没有被关闭
关键词 with 语句就可以保证诸如文件之类的对象在使用完之后一定会正确的执行他的清理方法:
with open("myfile.txt") as f:
    for line in f:
        print(line, end="")
以上这段代码执行完毕后,就算在处理过程中出问题了,文件 f 总是会关闭
十、面向对象编程
Python 从设计之初就已经是一门面向对象的语言,正因为如此,在Python中创建一个类和对象是很容易的
1、面向对象技术简介
- 类(Class):用来描述具有相同的属性和方法的对象的集合。它定义了该集合中每个对象所共有的属性和方法。对象是类的实例
- 方法:类中定义的函数
- 类变量:类变量在整个实例化的对象中是公用的。类变量定义在类中且在函数体之外。类变量通常不作为实例变量使用
- 数据成员:类变量或者实例变量用于处理类及其实例对象的相关的数据
- 方法重写:如果从父类继承的方法不能满足子类的需求,可以对其进行改写,这个过程叫方法的覆盖(override),也称为方法的重写
- 局部变量:定义在方法中的变量,只作用于当前实例的类
- 实例变量:在类的声明中,属性是用变量来表示的,这种变量就称为实例变量,实例变量就是一个用 self 修饰的变量
- 继承:即一个派生类(derived class)继承基类(base class)的字段和方法。继承也允许把一个派生类的对象作为一个基类对象对待
- 实例化:创建一个类的实例,类的具体对象
- 对象:通过类定义的数据结构实例。对象包括两个数据成员(类变量和实例变量)和方法
和其它编程语言相比,Python 在尽可能不增加新的语法和语义的情况下加入了类机制
2、类定义
class ClassName:
    ......
类实例化后,可以使用其属性,实际上,创建一个类之后,可以通过类名访问其属性
3、类对象
类对象支持两种操作:属性引用和实例化
属性引用使用和 Python 中所有的属性引用一样的标准语法:obj.name
类对象创建后,类命名空间中所有的命名都是有效属性名
1)__ init __
类有一个名为 init() 的特殊方法(构造方法),该方法在类实例化时会自动调用
def __init__(self):
    self.data = []
2)self
代表类的实例,而非类
类的方法与普通的函数只有一个特别的区别——它们必须有一个额外的第一个参数名称,按照惯例它的名称是 self
class Test:
    def prt(self):
        print(self)
        print(self.__class__)

t = Test()
t.prt()
<__main__.Test instance at 0x100771878>
__main__.Test在上面的例子中,self 是一个指向类实例的引用,它在 init 构造函数中用于初始化实例的属性,也在 display_value 方法中用于访问实例的属性。通过使用 self,你可以在类的方法中访问和操作实例的属性,从而实现类的行为
4、类的方法
# 类定义
class people:

    # 定义基本属性
    name = ''
    age = 0
    # 定义私有属性,私有属性在类外部无法直接进行访问
    __weight = 0

    # 定义构造方法
    def __init__(self,n,a,w):
        self.name = n
        self.age = a
        self.__weight = w

    def speak(self):
        print("%s 说: 我 %d 岁。" %(self.name,self.age))
5、继承
子类(派生类 DerivedClassName)会继承父类(基类 BaseClassName)的属性和方法
BaseClassName(实例中的基类名)必须与派生类定义在一个作用域内。除了类,还可以用表达式,基类定义在另一个模块中时这一点非常有用:
class DerivedClassName(modname.BaseClassName):
    ......
实例:
class people:

    name = ''
    age = 0
    __weight = 0

    def __init__(self,n,a,w):
        self.name = n
        self.age = a
        self.__weight = w

    def speak(self):
        print("%s 说: 我 %d 岁。" %(self.name,self.age))

# 单继承示例
class student(people):
    grade = ''
    def __init__(self,n,a,w,g):
        # 调用父类的构函
        people.__init__(self,n,a,w)
        self.grade = g
    # 覆写父类的方法
    def speak(self):
        print("%s 说: 我 %d 岁了,我在读 %d 年级"%(self.name,self.age,self.grade))
6、多继承
# 多继承
class sample(speaker,student):
    a =''
    def __init__(self,n,a,w,g,t):
        student.__init__(self,n,a,w,g)
        speaker.__init__(self,n,t)
7、方法重写
如果你的父类方法的功能不能满足你的需求,你可以在子类重写你父类的方法,实例如下:
class Parent:
   def myMethod(self):
      print ('调用父类方法')

class Child(Parent):
   def myMethod(self):
      print ('调用子类方法')

c = Child()
c.myMethod()                # 子类调用重写方法
super(Child,c).myMethod()   # 用子类对象调用父类已被覆盖的方法
8、类属性与方法
(1)类的私有属性
__private_attrs:两个下划线开头,声明该属性为私有,不能在类的外部被使用或直接访问
在类内部的方法中使用时: self.__private_attrs
(2)类的方法
在类的内部,使用 def 关键字来定义一个方法,与一般函数定义不同,类方法必须包含参数 self,且为第一个参数,self 代表的是类的实例
self 的名字并不是规定死的,也可以使用 this,但是最好还是按照约定使用 self
(3)类的私有方法
__private_method:两个下划线开头,声明该方法为私有方法,只能在类的内部调用 ,不能在类的外部调用
在类内部的使用:self.__private_methods
(4)运算符重载
Python 同样支持运算符重载,我们可以对类的专有方法进行重载,实例如下:
class Vector:
   def __init__(self, a, b):
      self.a = a
      self.b = b

   def __str__(self):
      return 'Vector (%d, %d)' % (self.a, self.b)

   def __add__(self,other):
      return Vector(self.a + other.a, self.b + other.b)

v1 = Vector(2,10)
v2 = Vector(5,-2)
print (v1 + v2)
十一、类型注解
1、简介
类型注解(Type Hints) 是一种为代码添加”说明标签”的技术,明确地指出变量、函数参数和返回值应该是什么数据类型
简单来说,类型注解就是在代码中注明数据类型的语法,它的核心目的是:
- 提高代码可读性:让他人(以及未来的你)一眼就能看懂代码的意图
- 便于静态检查:在运行代码前,通过工具发现潜在的类型错误
- 增强IDE支持:让代码编辑器提供更准确的自动补全和提示
一个简单的例子:
# 没有类型注解
def greet(name):
    return f"Hello, {name}"

# 有类型注解
def greet(name: str) -> str:
    return f"Hello, {name}"
第二段代码明确指出了 name 应该是字符串类型(str),函数会返回一个字符串(-> str)
2、为什么需要类型注解?
Python 以其动态类型特性而闻名——你不需要提前声明变量的类型,解释器会在运行时自动推断。这虽然灵活,但也带来了问题:
- 代码难以理解:看到一个函数时,不清楚应该传入什么类型的数据
- 隐藏的bug:可能不小心传入了错误类型,直到运行时才报错
- 开发效率低:IDE无法提供准确的代码提示和补全
类型注解通过提供可选的类型信息来解决这些问题,让你的代码更加健壮和可维护
3、基础语法详解
(1)变量注解
从 Python 3.6 开始,你可以直接为变量添加类型注解:
name: str = "Alice"
age: int = 30
is_student: bool = False
scores: list = [95, 88, 91]说明:name: str 读作”变量 name 的类型是 str”
(2)函数注解
def greet(first_name: str, last_name: str) -> str:
    full_name = first_name + " " + last_name
    return "Hello, " + full_name
(3)参数默认值
你可以同时使用类型注解和默认值:
def say_hello(name: str, times: int = 1) -> str:
    return " ".join([f"Hello, {name}!"] * times)
4、复杂类型注解
基本的 str, int, list 很好用,但如果我们想表达”一个由整数组成的列表”该怎么办?
这时就需要 Python 的 typing 模块提供更强大的工具
(1)列表、字典等容器类型
from typing import List, Dict, Tuple, Set

# List[int] 表示这是一个只包含整数的列表
numbers: List[int] = [1, 2, 3, 4, 5]

# Dict[str, int] 表示这是一个键为字符串、值为整数的字典
student_scores: Dict[str, int] = {"Alice": 95, "Bob": 88}

# Tuple[int, str, bool] 表示这是一个包含整数、字符串、布尔值的元组
person_info: Tuple[int, str, bool] = (25, "Alice", True)

# Set[str] 表示这是一个只包含字符串的集合
unique_names: Set[str] = {"Alice", "Bob", "Charlie"}
(2)可选类型(Optional)
当值可能是某种类型或者是 None 时使用:
from typing import Optional

def find_student(name: str) -> Optional[str]:
    """根据名字查找学生,可能找到也可能返回None"""
    students = {"Alice": "A001", "Bob": "B002"}
    return students.get(name)  # 可能返回字符串或None

# 等价于 Union[str, None]
(3)联合类型(Union)
当值可能是多种类型之一时使用:
from typing import Union

def process_input(data: Union[str, int, List[int]]) -> None:
    """处理可能是字符串、整数或整数列表的输入"""
    if isinstance(data, str):
        print(f"字符串: {data}")
    elif isinstance(data, int):
        print(f"整数: {data}")
    elif isinstance(data, list):
        print(f"列表: {data}")

process_input("hello")    # 输出:字符串: hello
process_input(42)         # 输出:整数: 42
process_input([1, 2, 3])  # 输出:列表: [1, 2, 3]
5、类型检查
(1)使用 Mypy 进行静态类型检查
Mypy 是最流行的 Python 类型检查器。首先安装它:
pip install mypy假设我们有一个有潜在类型问题的文件 example.py,运行 mypy 检查:
mypy example.py(2)在 IDE 中实时检查
现代 IDE(如 VS Code、PyCharm)都内置了类型检查支持:
- 错误高亮:类型不匹配的代码会被标记出来
- 智能提示:输入代码时会显示参数和返回值的类型信息
- 自动补全:基于类型信息提供更准确的代码补全建议
6、最佳实践指南
-
保持一致性 在项目中保持统一的注解风格,团队协商决定注解的详细程度
-
避免过度注解
-
处理第三方库
对于没有类型注解的第三方库,可以:
- 查看是否有对应的类型存根文件(通常叫
types-packageName) - 使用
Any类型暂时绕过检查 - 或者为常用函数添加自己的类型注解
- 查看是否有对应的类型存根文件(通常叫
7、常见问题解答
(1)类型注解会影响性能吗?
不会
类型注解在运行时会被忽略,只用于静态分析和开发工具
(2)必须使用类型注解吗?
不强制
Python 仍然是动态类型语言,类型注解是可选的。但强烈推荐使用,特别是大型项目
(3)如果注解错了会怎么样?
类型检查器会报错,但程序仍然可以运行。注解只是”提示”而不是”强制”
十二、Python 并发编程
1、前言
(1)为什么要引入并发编程?
在编写普通 Python 顺序执行(串行)程序的时候,代码按照从上到下的顺序一行一行执行,上一段逻辑没有执行完毕,后面的代码就会处于等待状态
很多场景下程序会遇到等待阻塞:比如网络请求等待远程接口返回数据、读写磁盘文件、数据库查询、接口调用、等待用户输入等。这类任务 CPU 本身几乎没有运算压力,大部分时间都在原地等待 IO 完成
并发编程就是为了解决这类痛点,它允许程序在等待某个任务阻塞的时候,转而去执行其他任务,不用卡死在原地等待
并发不等于同一时刻多核同时计算(那是并行),对于 IO 密集型任务,并发通过合理调度任务,把 CPU 空闲时间利用起来,大幅提升整体吞吐量
(2)有哪些程序提速的方法?
- 单线程串行:不加改造的程序
- 多线程并行:threading
- 多 CPU 并行:multiprocessing
- 多机器并行:hadoop / hive / spark
(3)Python 对并发编程的支持:
- 多线程:threading,利用 CPU 和 IO 可以同时执行的原理,让 CPU 不会干巴巴等待 IO 完成
- 多进程:multiprocessing,利用多核 CPU 的能力,真正的并行执行任务
- 异步 IO :asyncio,在单线程利用 CPU 和 IO 同时执行的原理,实现函数异步执行
- 使用 LOCK 对资源加锁,防止冲突访问
- 使用 Queue 实现不同线程 / 进程之间的数据通信,实现生产者-消费者模式
- 使用线程池 Pool / 进程池 Pool,简化线程 / 进程的任务提交、等待结束、获取结果
- 使用 subprocess 启动外部程序的进程,并进行输入输出交互
2、如何选择多线程、多进程、多协程
(1)什么是 CPU 密集型计算、IO 密集型计算?
1) CPU 密集型(CPU-bound)
CPU 密集型也叫计算密集型,是指 I/O 在很短的时间就可以完成,CPU 需要大量的计算和处理,特点是 CPU 占用率相当高
例如:压缩解压缩、加密解密、正则表达式搜索
2)IO 密集型(I / O bound)
IO 密集型指的是系统运作大部分的状况是 CPU 在等 I/O (硬盘 / 内存) 的读 / 写操作,CPU 占用率仍然较低
例如:文件处理程序、网络爬虫程序、读写数据库程序
(2)多线程、多进程和多协程对比
- 多进程 Process(multiprocessing)
- 多线程 Thread(threading)
- 多协程 Coroutine(asyncio)
| 优点 | 缺点 | 适用场景 | |
|---|---|---|---|
| 多进程 | 可以利用多核 CPU 并行运算 | 占用资源最多、可启动数目比线程少 | CPU 密集型计算 |
| 多线程 | 相比进程,更轻量级、占用资源少 | 相比进程:多线程只能并发执行,不能利用多 CPU(GIL) 相比协程:启动数目有限制,占用内存资源,有线程切换开销 | IO 密集型计算、同时运行的任务数目要求不多 |
| 多协程 | 内存开销最少、启动协程数量最多 | 支持的库有限制(aiohttp vs requests)、代码实现复杂 | IO 密集型计算、需要超多任务运行、但有现成库支持的场景 |
- 一个进程中可以启动 N 个线程
- 一个线程中可以启动 N 个协程
(3)怎么选择多线程、多进程和多协程?
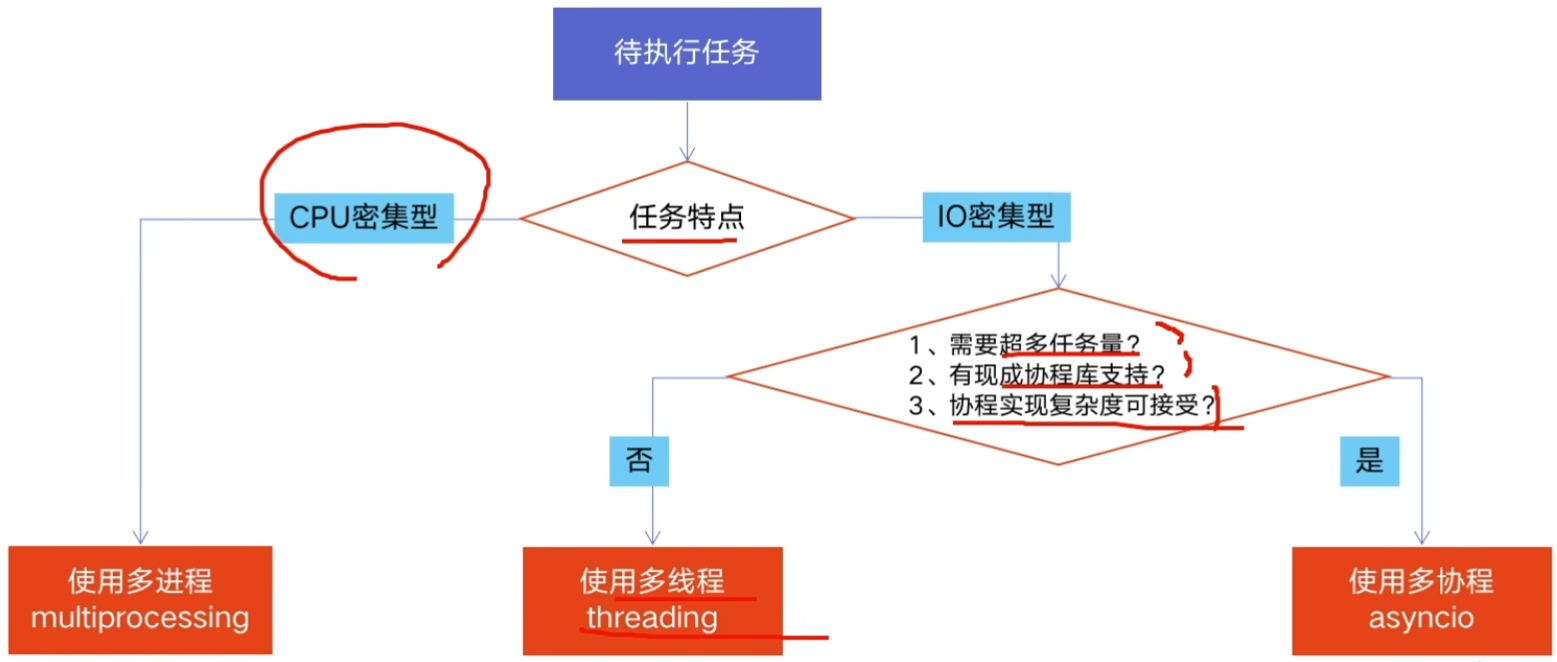
3、GIL(全局解释器锁)
(1)Python 速度慢的两大原因
在一些特殊的场景下,Python 比 C++ 慢 100 - 200 倍
由于速度慢的原因,很多公司的基础架构代码依然用 C/C++ 开发,比如各大公司阿里 / 腾讯 / 快手的推荐引擎、搜索引擎、存储引擎等底层对性能要求高的模块
- 原因 1:动态类型语言,边解释边执行
- 原因 2:GIL,无法利用多核 CPU 并发执行
(2)GIL 是什么?
全局解释器锁(英语:Global Interpreter Lock,缩写 GIL),是计算机程序设计语言解释器用于同步线程的一种机制,它使得任何时刻仅有一个线程在执行。 即便在多核心处理器上,使用 GIL 的解释器也只允许同一时间执行一个线程
- When a thread is running, it holds the GIL:当一个线程正在运行时,它持有 GIL(全局解释器锁)
- GIL released on I/O (read,write,send,recv,etc.):在发生 I / O 操作(读、写、发送、接收等)时,GIL 会被释放
由于 GIL 的存在,即使电脑有多核 CPU,单个时刻也只能使用1个,相比并发加速的 C++ / JAVA 所以慢
(3)为什么有 GIL 这个东西?
简而言之:Python 设计初期,为了规避并发问题引入了 GIL,现在想去除却去不掉了!
为了解决多线程之间数据完整性和状态同步问题:
Python 中对象的管理,是使用引用计数器进行的,引用数为 0 则释放对象
假如线程 A 和线程 B 都引用了对象 obj,obj.ref_num = 2,线程 A 和 B 都想撤销对 obj 的引用
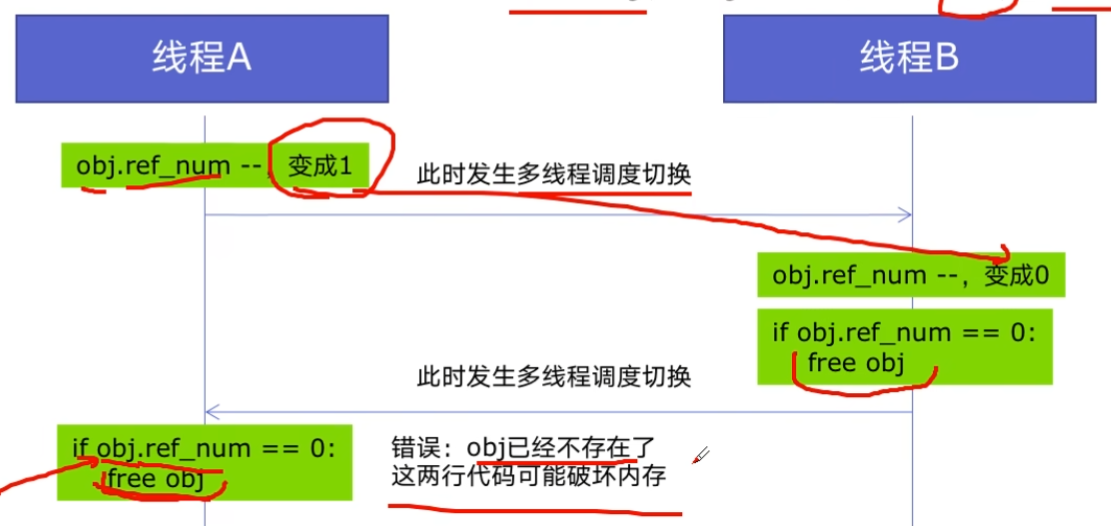
GIL 确实有好处: 简化了 Python 对共享资源的管理
(4)怎么规避 GIL 带来的限制?
1)多线程 threading 机制依然是有用的,用于 IO 密集型计算
因为在 I/O (read,write,send,recv,etc.) 期间,线程会释放 GIL,实现 CPU 和 IO 的并行 因此多线程用于 IO 密集型计算依然可以大幅提升速度
但是多线程用于 CPU 密集型计算时,只会更加拖慢速度
2)使用 multiprocessing 的多进程机制实现并行计算、利用多核 CPU 优势
为了应对 GIL 的问题,Python 提供了 multiprocessing
4、使用多线程
(1)Python 创建多线程的方法
- 准备一个函数
- 创建一个线程
- 启动线程
- 等待结束
# 1、准备一个函数
def my_func(a, b):
    do_craw(a, b)

# 2、创建一个线程
import threading
t = threading.Thread(target=my_func, args=(100, 200))

# 3、启动线程
t.start()

# 4、等待结束
t.join()
(2)改写爬虫程序,变成多线程爬取
import requests
import threading
import time


urls = [
    f"https://www.cnblogs.com/#p{page}"
    for page in range(1, 51)
]

def crawl(url):
    r = requests.get(url)
    print(url, len(r.text))

def single_spider():
    print("single_spider begin")
    for url in urls:
        crawl(url)
    print("single_spider end")

def multi_spider():
    print("multi_spider begin")
    threads = []
    for url in urls:
        threads.append(
            threading.Thread(target=crawl, args=(url,))
        )
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()
    print("multi_spider end")

if __name__ == '__main__':
    start = time.time()
    single_spider()
    end = time.time()
    print("single_spider cost", end - start, " seconds")

    start = time.time()
    multi_spider()
    end = time.time()
    print("multi_spider cost", end - start, " seconds")
"""
single_spider end
single_spider cost 19.06782579421997  seconds

multi_spider end
multi_spider cost 0.66741943359375  seconds
"""
可以看到,多线程加速的效果非常明显
5、实战:实现生产者消费者爬虫
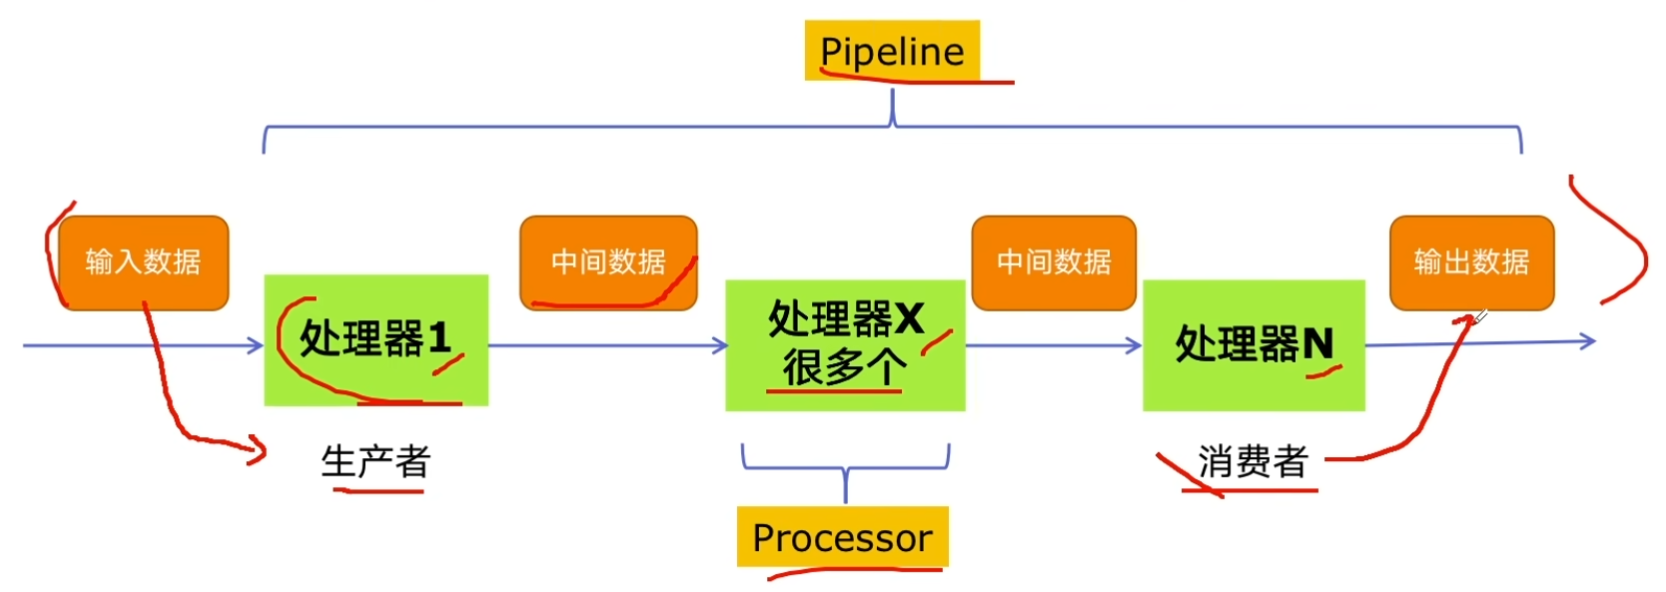
(1)多组件的 Pipeline 技术架构
复杂的事情一般都不会一下子做完,而是会分很多中间步骤一步一步完成,降低整体复杂度
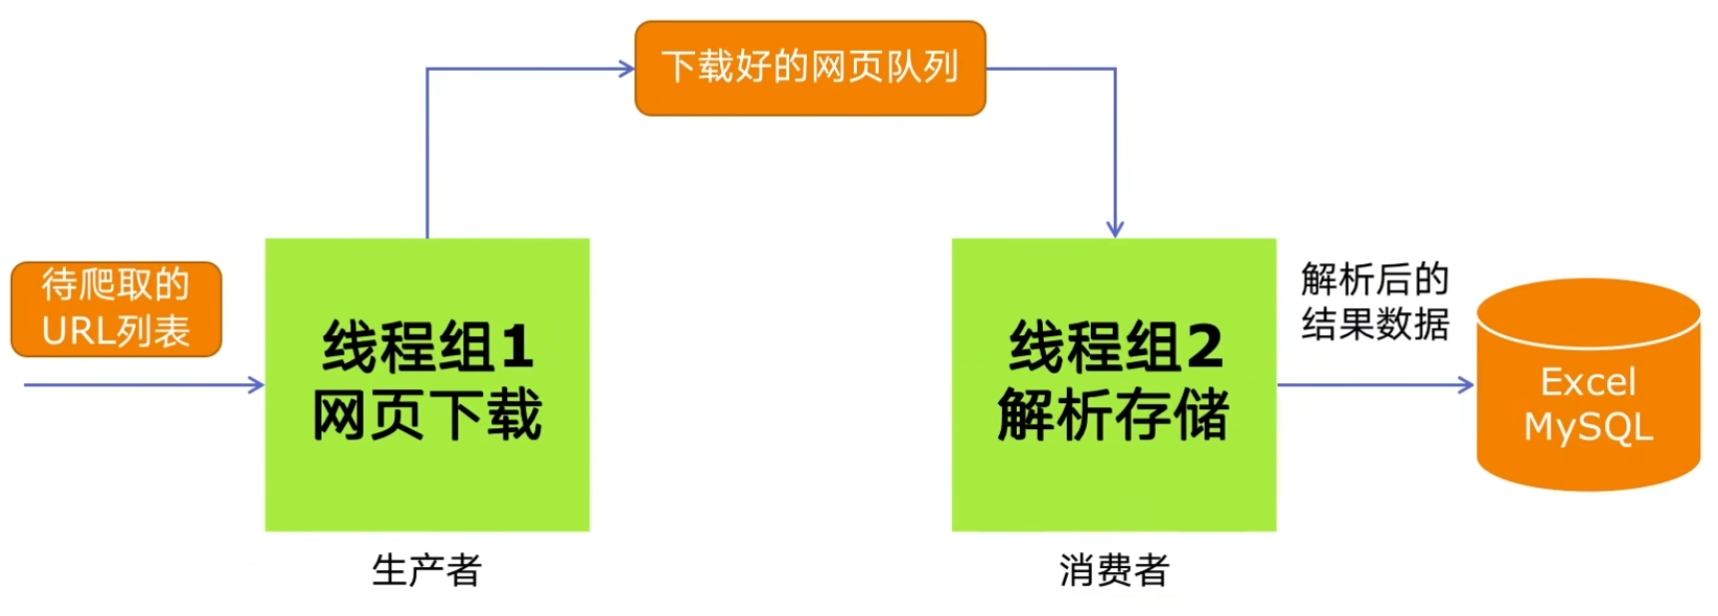
(2)生产者消费者爬虫的架构
(3)多线程数据通信的 queue.Queue
queue.Queue 可以用于多线程之间的、线程安全的数据通信
使用流程:
- 导入类库
- 创建 Queue
- 添加元素
- 获取元素
- 查询状态
# 1、导入类库
import queue

# 2、创建Queue
q = queue.Queue()

# 3、添加元素,阻塞性
q.put(item)

# 4、获取元素,阻塞性
item = q.get()

# 5、查询状态
# 查看元素的多少
q.qsize()
# 判断是否为空
q.empty()
# 判断是否已满
q.full()
(4)代码编写实现生产者消费者爬虫
1)blog_spider.py
import requests
from bs4 import BeautifulSoup


urls = [
    f"https://www.cnblogs.com/#p{page}"
    for page in range(1, 51)
]

def crawl(url):
    r = requests.get(url)
    return r.text

def parse(html):
    # post-item-title
    soup = BeautifulSoup(html, 'html.parser')
    links = soup.find_all('a', class_='post-item-title')
    return [(link["href"], link.get_text()) for link in links]
2)producer_consumer_spider.py
import queue
import blog_spider
import time
import random
import threading


def do_crawl(url_queue: queue.Queue, html_queue: queue.Queue):
    while True:
        url = url_queue.get()
        html = blog_spider.crawl(url)
        html_queue.put(html)
        print(threading.current_thread().name, f"craw {url}", "url_queue.size=", url_queue.qsize())
        time.sleep(random.randint(1,2))

def do_parse(html_queue: queue.Queue, fout):
    while True:
        html = html_queue.get()
        results = blog_spider.parse(html)
        for result in results:
            fout.write(str(result) + "\n")
        print(threading.current_thread().name, f"results.size", len(results), "html_queue.size=", html_queue.qsize())
        time.sleep(random.randint(1,2))


if __name__ == '__main__':
    url_queue = queue.Queue()
    html_queue = queue.Queue()
    for url in blog_spider.urls:
        url_queue.put(url)

    for idx in range(3):
        t = threading.Thread(target=do_crawl, args=(url_queue, html_queue), name=f"craw {idx}")
        t.start()

    fout = open("data.txt", "w")
    for idx in range(2):
        t = threading.Thread(target=do_parse, args=(html_queue, fout), name=f"parse {idx}")
        t.start()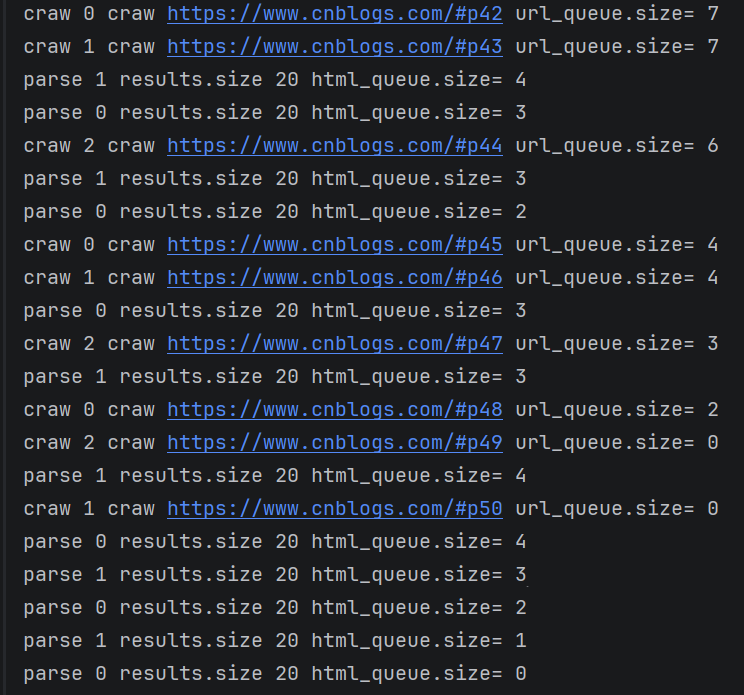
6、Python 线程安全问题
(1)线程安全概念
线程安全指某个函数、函数库在多线程环境中被调用时,能够正确地处理多个线程之间的共享变量,使程序功能正确完成
由于线程的执行随时会发生切换,就造成了不可预料的结果,出现线程不安全
def draw(account, amount):
    if account.balance >= amount:
        account.balance -= amount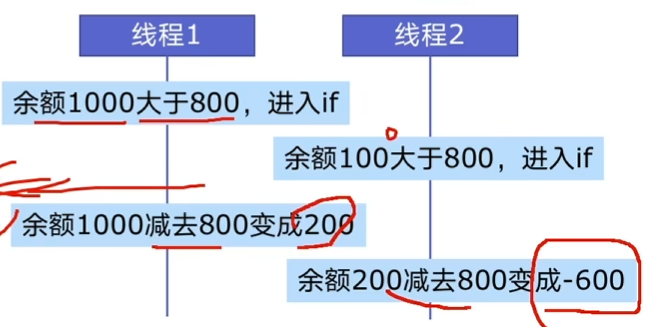
import threading

class Account:
    def __init__(self, balance):
        self.balance = balance

def draw(account, amount):
    if account.balance >= amount:
        print(threading.current_thread().name,
              "取钱成功")
        account.balance -= amount
        print(threading.current_thread().name,
              "余额", account.balance)
    else:
        print(threading.current_thread().name,
              "取钱失败,余额不足")

if __name__ == "__main__":
    account = Account(1000)
    ta = threading.Thread(name="ta", target=draw, args=(account, 800))
    tb = threading.Thread(name="tb", target=draw, args=(account, 800))

    ta.start()
    tb.start()
以上这个例子中,多次运行会出现下面两种情况:
ta 取钱成功
ta 余额 200
tb 取钱失败,余额不足
ta 取钱成功
ta 余额 200
tb 取钱成功
tb 余额 -600这说明只要线程1 进入 if 而没有执行减法时切换线程,线程 2 进入 if 就会出问题,但这个问题不是一定会触发,没有出现问题的时候就会输出第一种结果。我们在 if account.balance >= amount: 下添加 time.sleep ,可以 100% 触发问题:
ta 取钱成功
ta 余额 200
tb 取钱成功
tb 余额 -600(2)Lock 用于解决线程安全问题
1)用法 1 try-finally 模式
import threading

lock = threading.Lock()

lock.acquire()
try:
    # do something
finally:
    lock.release()
2)用法 2:with 模式
import threading

lock = threading.Lock()

with lock:
    # do something
(3)实例代码演示
# with 模式解决例子中的线程安全问题

import threading
import time

lock = threading.Lock()

class Account:
    def __init__(self, balance):
        self.balance = balance

def draw(account, amount):
    with lock:
        if account.balance >= amount:
            time.sleep(0.1)
            print(threading.current_thread().name,
                  "取钱成功")
            account.balance -= amount
            print(threading.current_thread().name,
                  "余额", account.balance)
        else:
            print(threading.current_thread().name,
                  "取钱失败,余额不足")


if __name__ == "__main__":
    account = Account(1000)
    ta = threading.Thread(name="ta", target=draw, args=(account, 800))
    tb = threading.Thread(name="tb", target=draw, args=(account, 800))

    ta.start()
    tb.start()
此时不管运行多少次都不会出现第二种的输出结果
7、线程池
(1)线程池原理
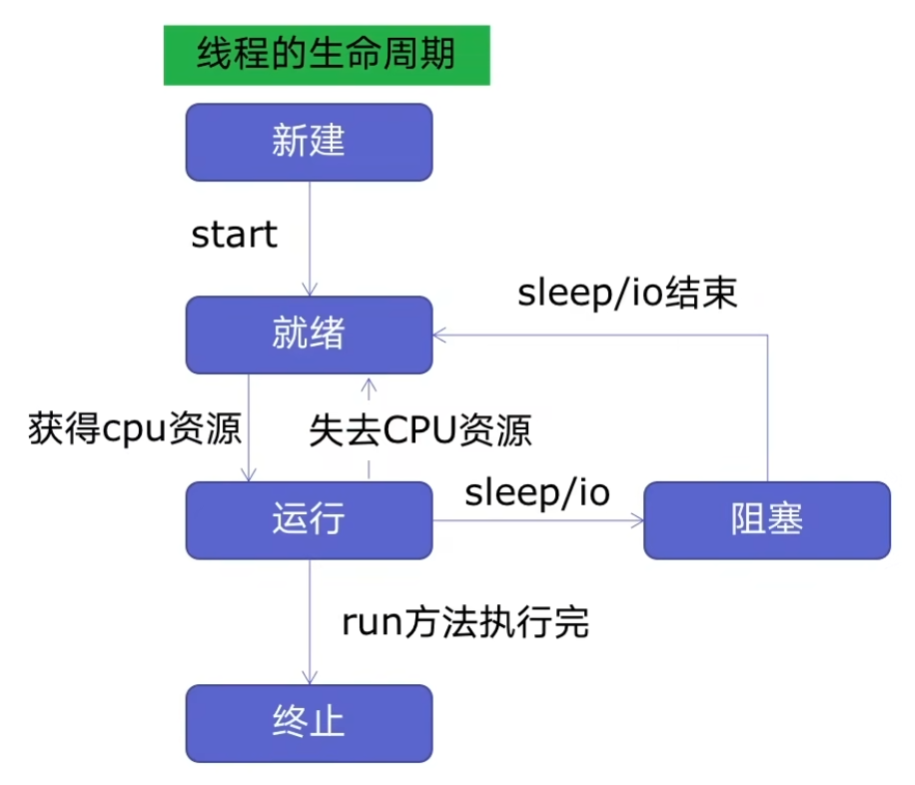
新建线程系统需要分配资源、终止线程系统需要回收资源 如果可以重用线程,则可以减去新建 / 终止的开销
这就是线程池的设计初衷,复用线程,避免频繁创建销毁线程带来的性能损耗
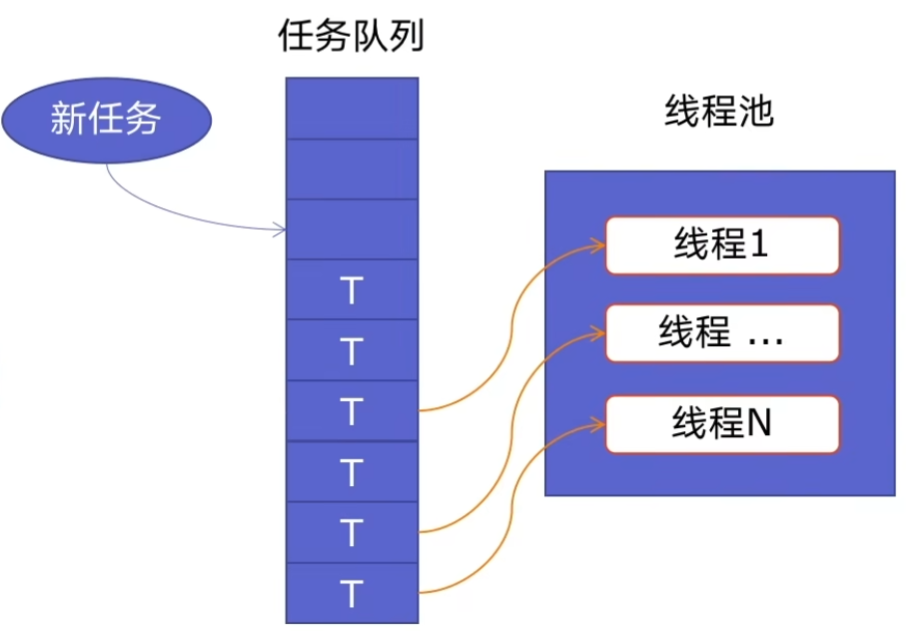
(2)使用线程池的好处
- 提升性能:因为减去了大量新建、终止线程的开销,重用了线程资源
- 适用场景:适合处理突发性大量请求或需要大量线程完成任务、但实际任务处理时间较短
- 防御功能:能有效避免系统因为创建线程过多,而导致系统负荷过大相应变慢等问题
- 代码优势:使用线程池的语法比自己新建线程执行线程更加简洁
(3)ThreadPoolExecutor 使用语法
from concurrent.futures import ThreadPoolExecutor, as_completed1)用法 1:map 函数,很简单
with ThreadPoolExecutor() as pool:

    results = pool.map(craw, urls)

    for result in results:
        print(result)
注意:map 的结果和入参是顺序对应的,result 会挨个返回对应的 url 结果
2)用法 2:future 模式,更强大
with ThreadPoolExecutor() as pool:

    futures = [ pool.submit(craw, url)
                for url in urls ]

    # 第一种写法
    for future in futures:
        print(future.result())

    # 第二种写法
    # 好处:对比 map 函数方法(result 会挨个返回对应的 url 结果),该写法实现先执行完的任务先返回
    for future in as_completed(futures):
        print(future.result())
注意:如果用 as_completed 顺序是不定的
(4)使用线程池改造爬虫程序
import concurrent.futures
from concurrent.futures import ThreadPoolExecutor, as_completed
import blog_spider

with concurrent.futures.ThreadPoolExecutor() as pool:
    htmls = pool.map(blog_spider.crawl, blog_spider.urls)
    htmls = list(zip(blog_spider.urls, htmls))
    for url, html in htmls:
        print(url, len(html))
print("craw over")

with concurrent.futures.ThreadPoolExecutor() as pool:
    futures = {}
    for url, html in htmls:
        future = pool.submit(blog_spider.parse, html)
        futures[future] = url

    # 第一种写法
    # for future,url in futures.items():
    #     print(url, future.result())

    # 第二种写法
    for future in concurrent.futures.as_completed(futures):
        url = futures[future]
        print(url, future.result())
print("future over")
8、在 Web 服务中使用线程池加速
(1)Web 服务架构以及特点
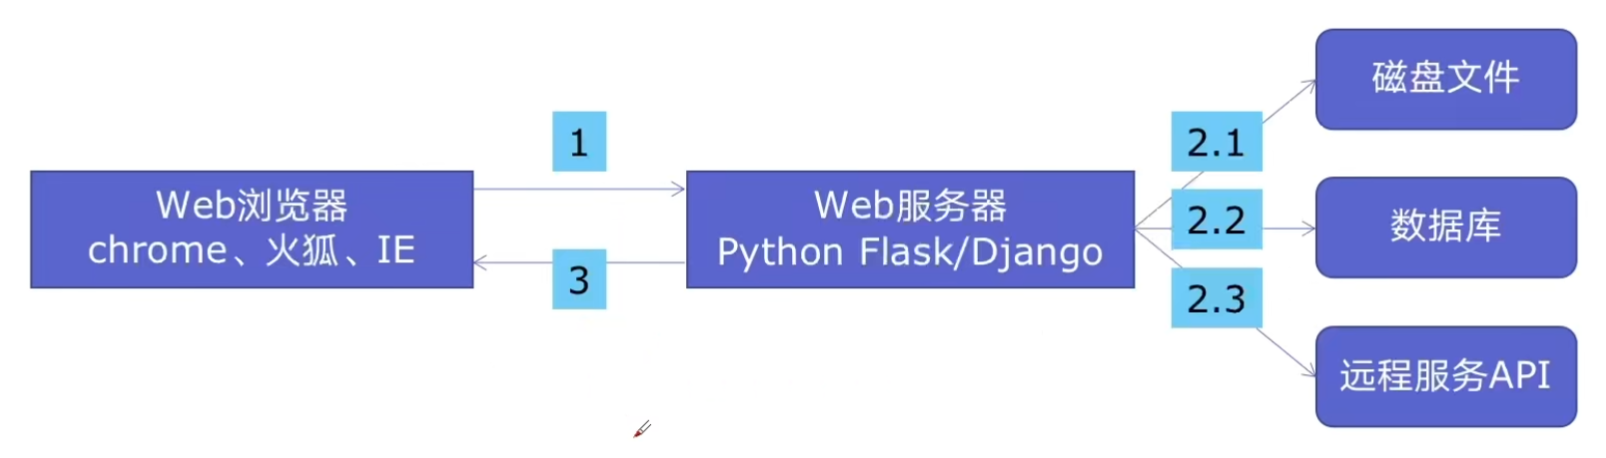
Web 后台服务的特点:
- Web 服务对响应时间要求非常高,比如要求 200ms 返回
- Web 服务有大量的依赖 IO 操作的调用,比如磁盘文件、数据库、远程 API
- Web 服务经常需要处理几万人、几百万人的同时请求
(2)使用线程池 ThreadPoolExecutor 加速
使用线程池 ThreadPoolExecutor 的好处:
- 方便的将磁盘文件、数据库、远程 API 的 IO 调用并发执行
- 线程池的线程数目不会无限创建(导致系统挂掉),具有防御功能
(3)用 Flask 搭建 Web 服务并实现加速
下面的例子中,我们用 Flask 框架搭建起了一个简单的 Web 框架,用 time.sleep 模拟 I / O 操作
import flask
import json
import time

app = flask.Flask(__name__)

def read_file():
    time.sleep(0.1)
    return "file result"

def read_db():
    time.sleep(0.2)
    return "db result"

def read_api():
    time.sleep(0.3)
    return "api result"

@app.route("/")
def index():
    result_file = read_file()
    result_db = read_db()
    result_api = read_api()

    return json.dumps({
        "result_file": result_file,
        "result_db": result_db,
        "result_api": result_api,
    })

if __name__ == "__main__":
    app.run()
请求响应的时间为 0.1 s + 0.2 s + 0.3 s + 程序框架耗费时间,至少花费 600 ms,我们可以用 Postman 请求网址,查看实际花费时间:
可以看到,总花费时间为 608 ms,接下来我们用 ThreadPoolExecutor 加速:
import flask
import json
import time
from concurrent.futures import ThreadPoolExecutor

app = flask.Flask(__name__)
pool = ThreadPoolExecutor()

def read_file():
    time.sleep(0.1)
    return "file result"

def read_db():
    time.sleep(0.2)
    return "db result"

def read_api():
    time.sleep(0.3)
    return "api result"

@app.route("/")
def index():
    # future 对象
    result_file = pool.submit(read_file)
    result_db = pool.submit(read_db)
    result_api = pool.submit(read_api)


    return json.dumps({
        "result_file": result_file.result(),
        "result_db": result_db.result(),
        "result_api": result_api.result(),
    })

if __name__ == "__main__":
    app.run()
可以看到,花费的时间从 608 ms 降低到了 305 ms,这是因为三个函数同时并行,花费的时间是由最长时间 read_api 的 300 ms 加上程序框架耗费的时间来决定
9、使用多进程 multiprocessing 加速程序的运行
(1)有了多线程为啥还要用多进程?
如果遇到了 CPU 密集型计算,多线程反而会降低执行速度!
虽然有全局解释器锁 GIL,但是因为有 IO 的存在,多线程依然可以加速运行
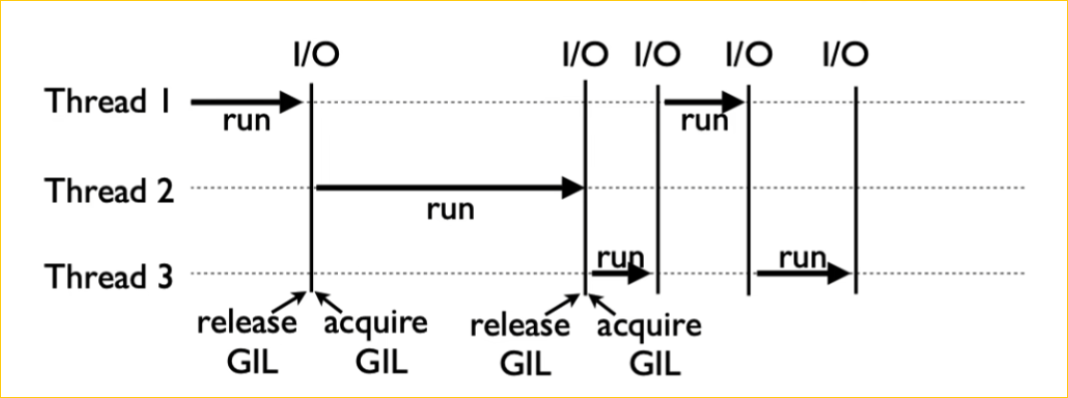
CPU 密集型计算,线程的自动切换反而变成了负担,多线程甚至减慢了运行速度
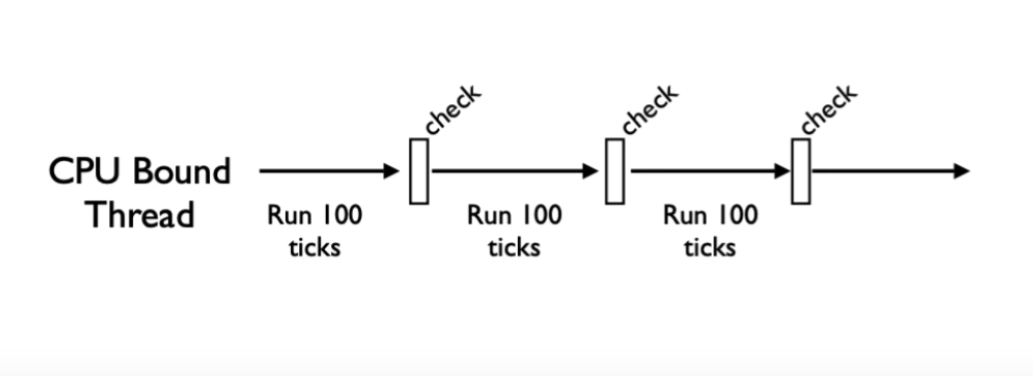
multiprocessing 模块就是 python 为了解决 GIL 缺陷引入的一个模块,原理是用多进程在多核 CPU 上并行执行
(2)多进程知识梳理
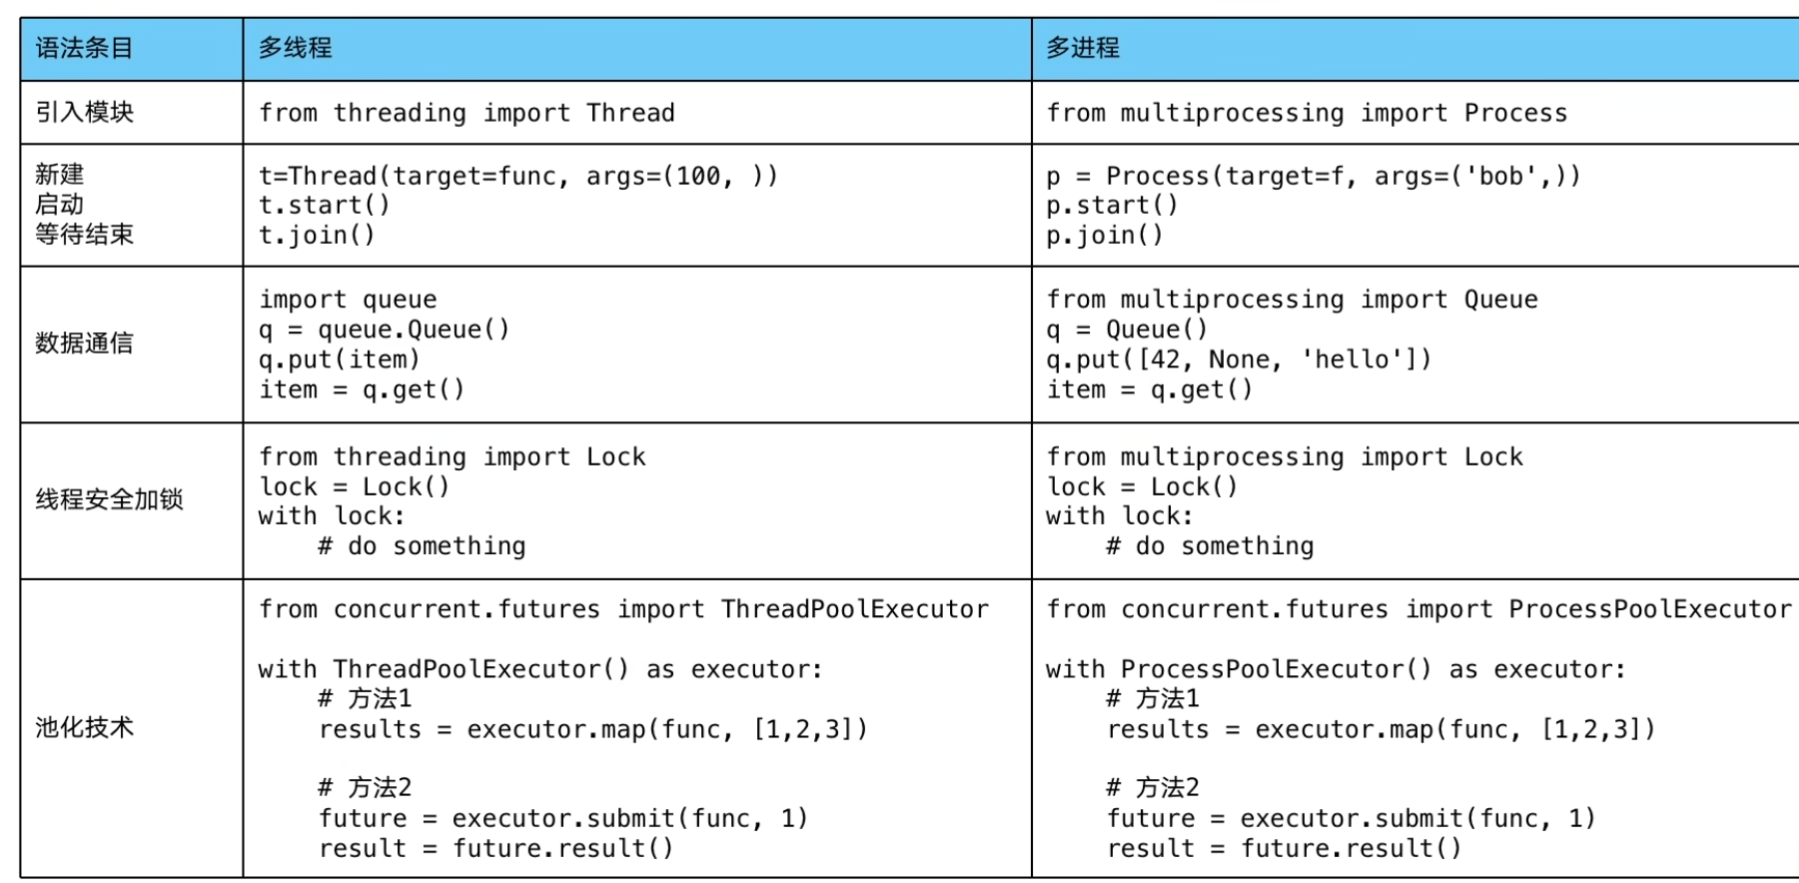
(3)单线程、多线程、多进程对比 CPU 密集计算速度
CPU 密集型计算:100 次 “判断大数字是否是素数” 的计算
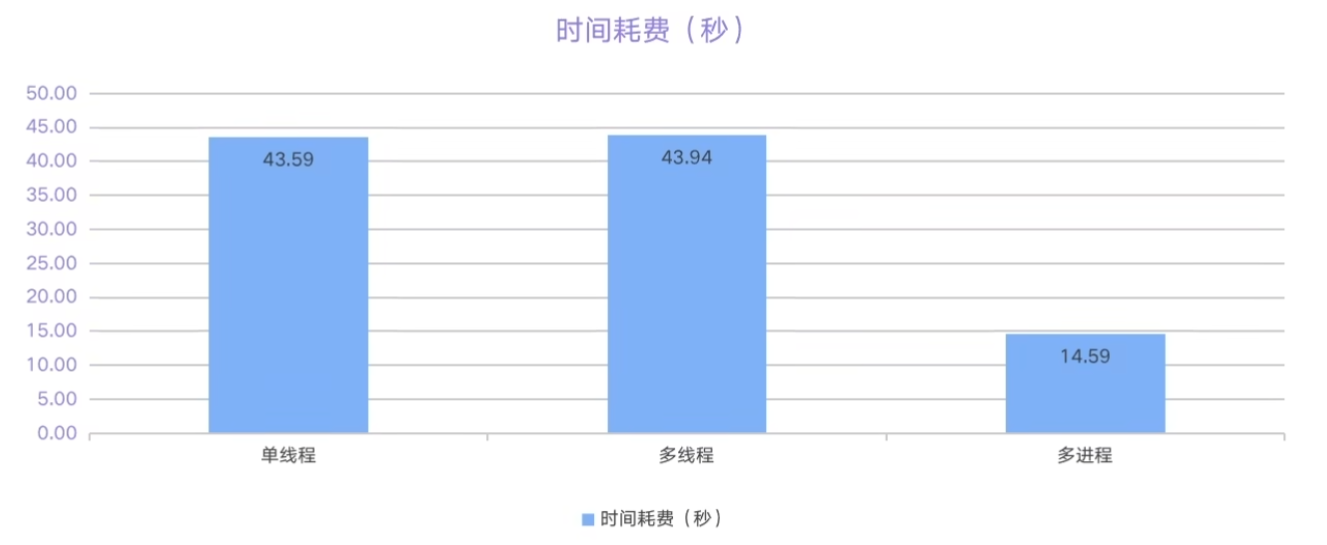
由于 GIL 的存在,多线程比单线程计算的还慢,而多进程可以明显加快执行速度
import math
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor
import time

PRIMES = [112272535095293] * 100

def is_prime(n):
    if n < 2:
        return False
    if n == 2:
        return True
    if n % 2 == 0:
        return False
    sqrt_n = int(math.floor(math.sqrt(n)))
    for i in range(3, sqrt_n + 1, 2):
        if n % i == 0:
            return False
    return True

def single_thread():
    for number in PRIMES:
        is_prime(number)

def multi_thread():
    with ThreadPoolExecutor() as pool:
        pool.map(is_prime, PRIMES)

def multi_process():
    with ProcessPoolExecutor() as pool:
        pool.map(is_prime, PRIMES)

if __name__ == '__main__':
    start = time.time()
    single_thread()
    end = time.time()
    print("single_thread cost: ", end - start, " seconds")

    start = time.time()
    multi_thread()
    end = time.time()
    print("multi_thread cost: ", end - start, " seconds")

    start = time.time()
    multi_process()
    end = time.time()
    print("multi_process cost: ", end - start, " seconds")
single_thread cost: 21.561853170394897 seconds
multi_thread cost: 21.167113780975342 seconds
multi_process cost: 4.928356647491455 seconds10、在 Flask 服务中使用进程池加速
import flask
from concurrent.futures import ProcessPoolExecutor
import math
import json

process_pool = ProcessPoolExecutor()
app = flask.Flask(__name__)

def is_prime(n):
    if n < 2:
        return False
    if n == 2:
        return True
    if n % 2 == 0:
        return False
    sqrt_n = int(math.floor(math.sqrt(n)))
    for i in range(3, sqrt_n + 1, 2):
        if n % i == 0:
            return False
    return True

@app.route("/is_prime/<numbers>")
def api_is_prime(numbers):
    number_list = [int(x) for x in numbers.split(",")]
    results = process_pool.map(is_prime, number_list)
    return json.dumps(dict(zip(number_list, results)))

app.run()
cur http://127.0.0.1:5000/is_prime/10,20,30,40
# {"10": false, "20": false, "30": false, "40": false}11、asyncio 协程
(1)简介
asyncio 本质上是单进程单线程的程序,并不能提升运算速度,比较适合处理需要等待的任务,最典型的就是网络通讯
asyncio 运算核心是 event loop,event loop 就像一个大脑,面对很多可以执行的任务,决定执行哪个任务
在 asyncio 里,同时执行的任务只能有一个,不存在系统级的上下文切换,需要每一个任务主动告诉 event loop:任务结束 —> 开始别的任务,所以不存在竞争冒险的问题
coroutine,task
(2)coroutine
- coroutine function:所有以 async def 开头的函数都是 coroutine function
- coroutine object:所有的 coroutine function 返回的都是 coroutine object
如下的代码:
import asyncio

async def main():
    print('hello')
    await asyncio.sleep(1)
    print('world')

coro = main()
函数 main 就是一个 coroutine function ,coro = main() 返回的是一个 coroutine object,所以当我们运行该 python 代码时会提示:
<sys>:0: RuntimeWarning: coroutine 'main' was never awaited我们需要按照如下步骤运行 coroutine 代码:
- 进入 async 模式(进入 event loop)
- 将 coroutine 变成 task
正常的 python 代码运行的时候是 synchronize 模式,用入口函数 asyncio.run() 即可,其中参数是一个 coroutine,其会做两件事:
- 建立起 event loop
- 将这个 coroutine 变成 event loop 中的第一个 task
asyncio.run(main())
# hello
# world
(3)增加 task 的方法
将 coroutine 变成 task,让他可以排队执行
1)await
import asyncio
import time

async def say_after(delay, what):
    await asyncio.sleep(delay)
    print(what)

async def main():
    print(f"started at {time.strftime('%X')}")

    await say_after(1, 'hello')
    await say_after(2, 'world')

    print(f"finished at {time.strftime('%X')}")

asyncio.run(main())这段代码中,asyncio.sleep(delay) 返回的也是一个 coroutine ,其前面加上 await 时,发生如下几事件:
- coroutine 被包装成一个 task,并且被告诉了 event loop 有一个新的 task
- 告诉 event loop,现在这个 task 需要等到 say_after task 完成之后才能继续
- yield 出去
- 当 event loop 再次安排它运行的时候,它会将 say_after 这个 coroutine 里真实的返回值拿出来保存
让我们拆解这段代码:
- asyncio.run(main()):将 main 作为一个 task 放到 vent loop 中,开始运行
- 在 main 中,首先执行了 print 函数,执行到第一个 await 时,将 say_after 这个 coroutine object 变成一个 task,放回 event loop 里,将控制权交给 event loop,现在 event loop 里有两个 task(一个时 main,一个是 say_after ,main 需要等待 say_after 运行)
- 同理,依次执行
- 当第二个 say_after 执行完后, event loop 中只有一个 task,控制权重新交给 main
其中所有控制权的返回都是显示的,即 event loop 没办法强行从一个 task 里拿回控制权,必须 task 主动交回控制权
2)create_task 函数
import asyncio
import time

async def say_after(delay, what):
    await asyncio.sleep(delay)
    print(what)

async def main():
    task1 = asyncio.create_task(
        say_after(1, 'hello'))

    task2 = asyncio.create_task(
        say_after(2, 'world'))

    print(f"started at {time.strftime('%X')}")

    await task1
    await task2

    print(f"finished at {time.strftime('%X')}")

asyncio.run(main())
create_task 函数的参数依旧是一个 coroutine,会将这个 coroutine 包装成一个 task
当第一个 say_after 被包装成 task 时,此时控制权依旧在 main 手里,main 将第二个 say_after 包装成 task
我们前面介绍:当 await 后面是一个 coroutine 时,会进行一系列事件,但是如果后面是一个 task 时,只是告诉 event loop 需要完成的任务,并且交还控制权, 在控制权交还回来的时候,从 task 里面提取所需要的返回值,event loop 中的任务会同时进行
由此可见 async 很适合解决一些网络通讯的问题,也就是所谓的 IO bound task
3)gather 函数
gather 的参数是若干个 coroutine 或者 task,甚至可以是 gather
- 如果参数是 coroutine:将其包装成 task,注册到 event loop 里,返回 futhre 值,当 await 这个 futhre 时,会告诉 event loop 需要等待里面每一个 task 都完成才继续,并且将这些 task 的 return 值放到一个 list 里,然后返回回来
- 如果参数是 task:不会重复创建新 task,直接复用已经在事件循环中调度运行的 task,同样等待全部传入 task 执行完毕,收集所有 task 的返回值,按传入 task 的顺序组装成列表返回。即使某个 task 执行抛出异常,gather 默认也会等待全部任务结束后再抛出异常
gather 不是一个 coroutine,但是会返回一个叫做 futhre 的东西,futhre 也可以用 await
# 参数是 coroutine
import asyncio
import time

async def say_after(delay, what):
    await asyncio.sleep(delay)
    return f"{what} - {delay}"

async def main():
    print(f"started at {time.strftime('%X')}")

    ret = await asyncio.gather(
        say_after(1, 'hello'),
        say_after(2, 'world')
    )

    print(ret)

    print(f"finished at {time.strftime('%X')}")

asyncio.run(main())
# 参数是 task
import asyncio
import time
async def say_after(delay, what):
await asyncio.sleep(delay)
return f"{what} - {delay}"
async def main():
task1 = asyncio.create_task(
say_after(1, 'hello'))
task2 = asyncio.create_task(
say_after(2, 'world'))
print(f"started at {time.strftime('%X')}")
ret = await asyncio.gather(task1, task2)
print(ret)
print(f"finished at {time.strftime('%X')}")
asyncio.run(main())started at 16:36:55
['hello - 1', 'world - 2']
finished at 16:36:57(4)总结
尽管我们说协程的方式是并发的,但是同时刻实际上只有一段代码在跑,协程只是想办法利用代码中间等待的时间,所以如果代码中没有“等待”这件事的话,协程是没有帮助的
十三、CPython 解释器
想要真正吃透 Python、看懂底层逻辑、解决线上性能问题、排查内存泄漏、OOM 异常、理解 GIL 锁的本质,就必须深入 Python 的核心运行载体——CPython 解释器
1、CPython 介绍
(1)什么是 CPython
简单来说:CPython 是使用 C 语言编写的 Python 解释器,是 Python 语言的官方标准实现
Python 是一门解释型高级语言,本身只定义了语法规范、运行规则和语义标准,没有固定的运行程序。而 CPython 就是这套规则的具体落地实现,也是我们从官网下载、日常安装使用的标准版 Python
市面上除了 CPython,还有其他 Python 解释器实现,例如:
- PyPy:JIT 即时编译解释器,运行速度远快于 CPython,适合纯计算场景
- Jython:基于 Java 实现,可无缝对接 Java 生态
- IronPython:基于 .NET 实现,适配 Windows 平台生态
(2) CPython 的核心运行机制
CPython 并非逐行简单直译执行代码,其整体执行流程分为两步:
第一步:预编译(字节码编译)
CPython 会先将我们编写的 .py 源码,编译为平台无关的 Python 字节码(Bytecode),生成对应的 .pyc 缓存文件,用于加速二次运行。这一步不属于机器码编译,只是源码的轻量化转换
第二步:解释执行
CPython 虚拟机(PVM)逐行解析、执行字节码,最终调用底层 C 代码完成逻辑运算、内存操作、IO 交互,实现程序运行
这也是 Python 跨平台的核心原因:只要对应平台装有 CPython 解释器,同一套字节码就可以正常运行,无需修改代码
(3)为什么要学 CPython 底层
如果我们只会调用 Python 语法和库函数,遇到实际问题可能无从下手,核心原因就是不懂 CPython 底层机制,学 CPython 底层可以让我们:
- 搞懂并发瓶颈:理解 GIL 锁为什么存在、为什么多线程无法利用多核、协程为何能实现高并发
- 解决内存问题:掌握对象内存模型、引用计数、垃圾回收机制,精准排查内存泄漏、程序卡顿、OOM 崩溃问题
- 读懂代码本质:明白变量、对象、深浅拷贝、作用域的底层存储逻辑,规避隐形 Bug
- 性能调优:根据底层机制合理选择多线程/多进程/协程,写出贴合 CPython 特性的高性能代码
2、内存模型
(1)环状双向链表 refchain
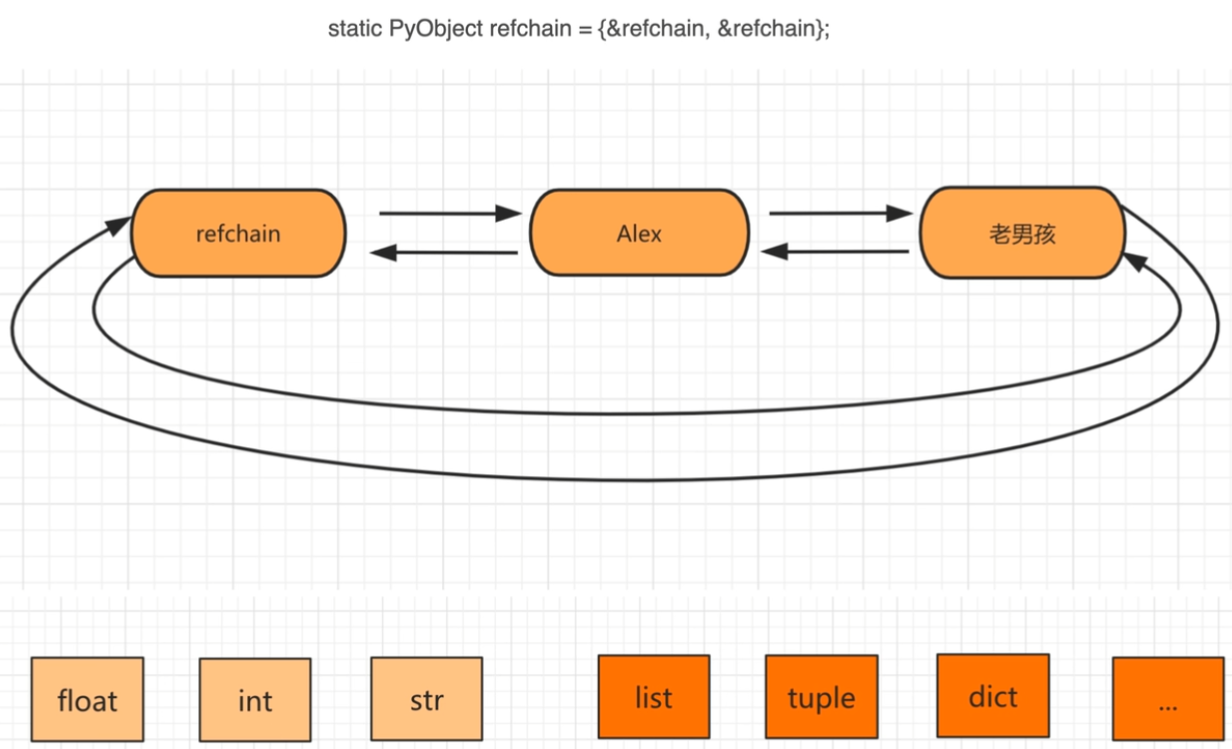
在 python 程序中创建的任何对象都会放在 refchain 链表中
name = "武沛齐"
age = 18
hobby = ["篮球",'美女']
不同对象放进 refchain 时,内部会创建一些数据,可以理解为:
name = "武沛齐"  # 内部会创建非语言结构体 【上一个对象、下一个对象、类型、引用个数】
new = name      # 不会创建两个“武沛齐”,而是让 new 也指向 “武沛齐”,结构体中“引用个数” + 1
age = 18 # 内部会创建一些数据【上一个对象、下一个对象、类型、引用个数、val=18】hobby = ["篮球",'美女'] # 内部会创建一些数据【上一个对象、下一个对象、类型、引用个数、items = 元素、元素个数】C 语言源码:
#define PyObject_HEAD        PyObject ob_base;
#define PyObject_VAR_HEAD    PyVarObject ob_base;

// 宏定义,包含 上一个、下一个,用于构造双向链表用 (放到refchain链表中时,要用到)
#define _PyObject_HEAD_EXTRA    \
    struct _object *_ob_next;   \
    struct _object *_ob_prev;

// PyObject 结构体
typedef struct _object {
    _PyObject_HEAD_EXTRA           // 用于构造双向链表
    Py_ssize_t ob_refcnt;          // 引用计数器
    struct _typeobject *ob_type;   // 数据类型
} PyObject;

// 变长对象(list/tuple)额外增加 ob_size 字段保存元素数量
typedef struct {
    PyObject ob_base; // PyObject对象
    Py_ssize_t ob_size; /* Number of items in variable part, 即: 元素个数 */
} PyVarObject;
在 C 源码中如何体现每个对象中都有的相同的值:PyObject 结构体(4 个值)
四个值分别:
_ob_next:双向链表下一个对象指针_ob_prev:双向链表上一个对象指针ob_refcnt:引用计数ob_type:对象类型指针
变长对象(list/tuple)会在 PyObject 基础上额外增加 ob_size 字段保存元素数量
(2)类型封装结构体
C 语言源码:
// float类型
typedef struct {
    PyObject_HEAD
    double ob_fval;
} PyFloatObject;

// int类型
struct _longobject {
    PyObject_VAR_HEAD
    digit ob_digit[1];
};
/* Long (arbitrary precision) integer object interface */
typedef struct _longobject PyLongObject; /* Revealed in lo */

// list类型
typedef struct {
    PyObject_VAR_HEAD
    PyObject **ob_item;
    Py_ssize_t allocated;
} PyListObject;

// tuple类型
typedef struct {
    PyObject_VAR_HEAD
    PyObject *ob_item[1];
} PyTupleObject;

// dict类型
typedef struct {
    PyObject_HEAD
    Py_ssize_t ma_used;
    PyDictKeysObject *ma_keys;
    PyObject **ma_values;
} PyDictObject;
例如当创建 data = 3.14 时,内部会创建:
- _ob_next = refchain 中的上一个对象
- _ob_prev = refchain 中的下一个对象
- ob_refcnt = 1
- ob_type = float
- ob_fval = 3.14
3、垃圾回收机制
提到垃圾回收机制,就会听到一句话:引用计数器为主,标记清除和分代回收为辅(记住这句话,忽悠一票人)
(1)引用计数器
v1 = 3.14
v2 = 999
v3 = (1,2,3)
当 python 程序运行时,会根据数据类型的不同找到其对应的结构体,根据结构体中的字段来进行创建相关的数据,然后将对象添加到 refchain 双向链表中
在 C 源码中有两个关键的结构体:PyObject 结构体、PyVarObject 结构体
每个对象中有 ob_refcnt 就是引用计数器,值默认为 1,当有其他变量引用对象时,引用计数器就会发生变化
1)引用
a = 99999
b = a
2)删除引用
a = 99999
b = a
del b  # b 变量删除;b 对应对象引用计数器 - 1
del a  # a 变量删除;a 对应对象引用计数器 - 1
当一个对象的引用计数器为 0 时,意味着没有人再使用这个对象了,这个对象就是垃圾,垃圾回收
回收:
- 对象从refchain链表移除
- 将对象销毁
- 内存归还
(2)循环引用 & 交叉感染
v1 = [11,22,33]   # refchain 中创建一个列表对象,由于 v1=对象,所以列表引对象用计数器为 1
v2 = [44,55,66]   # refchain 中再创建一个列表对象,因 v2=对象,所以列表对象引用计数器为 1
v1.append(v2)     # 把 v2 追加到 v1 中,则 v2 对应的 [44,55,66] 对象的引用计数器加 1,最终为 2
v2.append(v1)     # 把 v1 追加到 v2 中,则 v1 对应的 [11,22,33] 对象的引用计数器加 1,最终为 2
del v1            # 引用计数器 - 1
del v2            # 引用计数器 - 1
此时引用计数都不为 0,单纯依靠引用计数无法回收这两块内存,造成内存泄漏,这就是循环引用问题
(3)标记清除
目的:为了解决引用计数器循环引用的不足
实现:在 python 的底层再维护一个链表,链表中专门放那些可能存在循环引用的对象(list/tuple/dict/set)
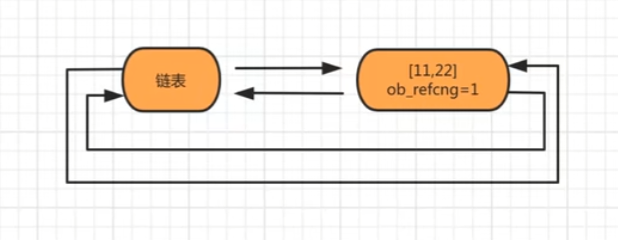
在 Python 内部某种情况下触发,回去扫描可能存在循环引用的链表中的每个元素,检查是否有循环引用,如果有则让双方的引用计数器 -1;如果是 0 则垃圾回收
问题:
- 什么时候扫描?
- 扫描代价大,每次扫描全部容器链表,会产生 STW,性能开销大
(4)分代回收
将可能存在循环引用的对象维护成 3 个链表:
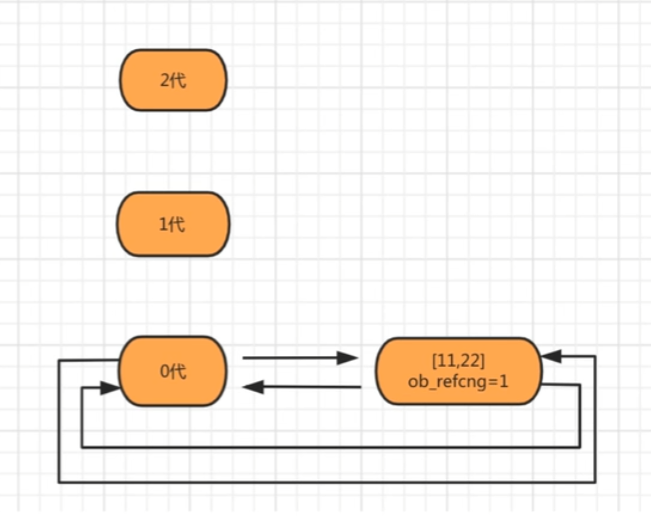
每一代都是一个双向链表
- 0 代:新创建容器对象放入 0 代
- 1 代:每次 0 代扫描,存活下来的对象晋升到 1 代
- 2 代:每次 1 代扫描,存活的对象晋升到 2 代
什么时候扫描?
- 0 代:0 代中对象个数达到 700 个扫描一次
- 1 代:0 代扫描 10 次,则 1 代扫描一次
- 2 代:1 代扫描 10 次,则 2 代扫描一次
分代回收基于弱分代假说:大多数对象都是朝生夕灭;存活越久的对象,越不容易是垃圾。
(5)小结
问:给我聊聊 python 的内存管理 / 垃圾回收机制
在 python 中维护了一个 refchain 的双向环状链表,这个链表中存储程序创建的所有对象,每种类型的对象中都有一个 ob_refcnt 引用计数器的值,引用个数 +1、-1,最后当引用计数器变为 0 时会进行垃圾回收(对象销毁、refchain 中移除)
但是,在 python 中对于那些可以有多个元素组成的对象可能会存在循环引用的问题,为了解决这个问题 python 又引入了标记清除和分代回收,在其内部为了 4 个链表:
- refchain
- 2 代,10 次
- 1 代,10 次
- 0 代,700 个
在源码内部当达到各自的阈值时,就会触发扫描链表进行标记清除的动作(有循环则各自 - 1)
但是,源码内部在上述的流程中提出了优化机制(缓存机制)
(6)缓存机制
1)池(int)
为了避免重复创建和销毁一些常见对象,维护池
# 启动解释器时,Python 内部帮我们创建常用的值(-5 到 257):-5、-4、…… 257
v1 = 7  # 内部不会开辟内存,直接去池中获取
v2 = 9  # 内部不会开辟内存,直接去池中获取
v3 = 9  # 内部不会开辟内存,直接去池中获取
print(id(v2), id(v3))
# 140703430571176 140703430571176
池中的这些数据永远不会被回收
2)free_list(float/list/tuple/dict)
当一个对象的引用计数器为 0 时,按理说应该回收,内部不会直接回收,而是将对象添加到 free_list 链表中当缓存。以后再去创建对象时,不再重新开辟内存,而是直接使用 free_list
v1 = 3.14   # 开辟内存,内部存储结构体中定义那几个值,并存到 refchain 中
del v1      # refchain 中移除,将对象添加到 free_list 中,free_list 满了则销毁
v9 = 999.99 # 不会重新开辟内存,去 free_list 中获取对象,对象内部数据初始化,再放到 refchain 中
free_list 有容量上限,满了之后再销毁对象就直接释放
4、GIL 全局解释器锁
在前面第九章并发编程中,我们发现一个很反直觉的现象:多线程在 CPU 密集型任务中,并不能利用多核 CPU 加速。而这个现象的根源,就是 CPython 解释器的 GIL(Global Interpreter Lock,全局解释器锁)
GIL 是 CPython 解释器独有的机制,PyPy、Jython 等其他 Python 解释器没有 GIL 锁
(1)GIL 是什么
GIL 本质上是一把互斥锁,它保护 CPython 虚拟机的字节码执行。规则非常简单: 任何时刻,同一个进程内,只能有一个线程拿到 GIL,执行 Python 字节码
哪怕你的机器是多核 CPU,同一个 Python 进程里的多个线程,也无法真正并行执行 Python 字节码,只能交替并发执行
GIL 锁保护的对象:
PyObject对象引用计数(就是我们内存模型章节里的ob_refcnt)- CPython 虚拟机内部全局状态
- refchain 双向链表等全局对象集合
诞生背景:早期开发 CPython 时,为了降低 C 扩展开发难度、简化内存对象并发安全问题,引入了 GIL。如果没有 GIL,开发者在写 C 扩展时,需要自己处理大量复杂的多线程锁竞争问题
(2)GIL 的工作原理与释放时机
-
IO 阻塞时主动释放 当线程遇到 IO 等待(网络请求、文件读写、sleep),会主动释放 GIL。IO 等待期间,其他线程可以获取 GIL 运行。这也是 IO 密集型场景,多线程依然可以提升效率的根本原因
-
时间片计数释放(CPU 密集场景) Python 设置了一个字节码执行计数器,线程每执行固定数量的字节码(Python3 默认是 100 条),就主动释放 GIL,触发线程竞争
注意:这里只是切换线程,不是并行,多个线程轮流抢锁,单核交替运行
-
C 扩展调用阻塞时: 如果调用耗时的 C 扩展函数(比如一些计算库),C 代码可以手动释放 GIL;如果 C 代码没有释放,会一直占用 GIL 直到执行完成
(3)GIL 对多线程 / 多进程 / 协程的影响
-
多线程
- IO 密集:GIL 会在 IO 等待释放,多线程有效,并发提速
- CPU 密集:同一时刻只能一个线程执行字节码,无法多核并行,多线程没有加速效果,锁竞争还会带来额外开销
-
多进程
不受 GIL 限制,每个进程拥有独立 CPython 解释器、独立 GIL。多个进程可以跑在多个 CPU 核心上,实现真正并行
代价:进程创建开销大,进程间内存隔离,通信成本高
-
asyncio 协程
协程是单线程内的用户态调度,依然受 GIL 约束。优势:没有线程切换开销,IO 场景并发能力更强;但 CPU 密集任务下,协程同样无法利用多核
选型回顾(见第九章):
- IO 密集:多线程 /asyncio 协程
- CPU 密集:必须使用多进程,绕开 GIL 限制
(4)GIL 的常见误区
误区 1:GIL 是 Python 语言的特性
纠正:只是 CPython 解释器的实现机制,不属于 Python 语法本身。PyPy、Jython 没有 GIL
误区 2:GIL 会导致 Python 多线程完全没用
纠正:IO 密集场景下 GIL 会释放,多线程可以正常并发处理 IO 任务,爬虫、接口请求场景大量使用
误区 3:GIL 锁保护 Python 代码里所有变量
纠正:GIL 只保护字节码执行层面,不等于线程安全。即使有 GIL,多个线程修改同一个可变对象依然会出现数据竞争问题。GIL ≠ 业务代码锁
import threading

num = 0
def add():
    global num
    for _ in range(100000):
        num += 1

t1 = threading.Thread(target=add)
t2 = threading.Thread(target=add)
t1.start()
t2.start()
t1.join()
t2.join()
print(num)      # 结果大概率小于200000,出现竞态
num +=1 不是原子操作,会拆成多条字节码,GIL 会在字节码之间切换,最终引发数据错乱。GIL 无法解决这个问题,业务代码仍然需要手动加threading.Lock
误区 4:GIL 会在函数执行完才释放
纠正:达到字节码计数或者遇到 IO 阻塞就会释放,函数没执行完也可以交出 GIL
(5)小结
GIL 是 CPython 历史遗留设计,它不是 bug,是为了简化 C 扩展开发、保护解释器全局状态
- IO 密集任务:GIL 影响很小,多线程、协程都适用
- CPU 密集任务:多线程无法多核并行,解决方案是多进程
- GIL ≠ 业务锁,GIL 存在不代表你的多线程代码天然线程安全
GIL 是 CPython 内存模型、并发编程的交汇点,理解 GIL 之后,我们就可以进入下一节:内存泄漏与 OOM 排查实战
5、内存泄漏与 OOM 排查
理论上:正常代码执行完毕后,引用会自动释放,GC 会自动回收垃圾对象,内存不会持续上涨
GC = Garbage Collection(垃圾回收),是 CPython 自动清理无效对象、释放内存的垃圾回收机制,是解决内存堆积、避免 OOM 的核心底层能力
但在实际项目、爬虫、Web 服务、长轮询、后台常驻程序中,我们经常遇到:程序越跑越卡、内存持续上涨、不释放、最终被系统杀死(OOM)
(1)什么是 Python 内存泄漏
在 C/C++ 中,内存泄漏通常是:手动开辟内存未释放
而在 Python 中定义完全不同:
Python 内存泄漏:程序逻辑导致本该销毁的对象,仍然被持有引用,GC 无法回收,内存只增不减,持续堆积
(2)Python 内存泄漏四大核心成因
1)长生命周期容器持有短生命周期对象
# 全局容器无限堆积
global_list = []

def task():
    # 每次任务产生临时对象,但被全局容器持有
    data = [i for i in range(10000)]
    global_list.append(data)

# 多次调用后,内存只涨不跌,永远无法被 GC 回收
for _ in range(100):
    task()
global_list 生命周期和程序一致,只要程序不重启,内部所有对象永久存活
2)循环引用
前面垃圾回收章节我们讲过:标记清除可以解决循环引用
但是存在例外情况:
如果循环引用的对象中,存在 __del__ 析构方法,CPython 垃圾回收器无法确定销毁顺序,会直接放弃回收,造成永久内存泄漏
3)线程常驻
后台线程、守护线程、循环线程异常卡住,线程不销毁,线程栈上的所有对象永久持有,无法释放
4)C 扩展 / 第三方库内存泄漏
numpy、opencv、底层 C 扩展手动申请内存,不受 Python GC 管控,Python GC 只能管 PyObject,管不了 C 层内存
这也是很多数据分析、图像处理项目莫名 OOM 的根源
(3)什么是 OOM?为什么会 OOM?
OOM(Out Of Memory):进程占用内存超过系统/容器最大限制,被操作系统强制杀死
Python 出现 OOM 几乎只有两类原因:
- 内存泄漏:内存缓慢上涨,日积月累打满上限
- 瞬时内存峰值:一次性加载超大文件、超大列表、批量数据无分片处理
(4)内存排查三大核心工具
1)tracemalloc(Python 内置)
import tracemalloc

# 开启内存追踪
tracemalloc.start()

# 模拟业务代码
data = [i for i in range(100000)]

# 获取内存占用
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')

for stat in top_stats[:5]:
print(stat)作用:精准定位哪一行代码内存占用最高,快速锁定泄漏位置
2)objgraph
pip install objgraphimport objgraph
# 查看数量最多的前10种对象
print(objgraph.show_most_common_types(limit=10))
# 查看某个对象的引用链(找到是谁持有它)
# objgraph.show_backrefs(obj)持续上涨 = 百分百泄漏
3)memory_profiler
pip install memory-profiler(5)标准内存泄漏排查流程
- 观察现象:内存是瞬时冲高,还是缓慢持续上涨
- 工具定位:用 tracemalloc 定位代码行,用 objgraph 定位泄漏对象
- 查找引用来源:找到是谁长期持有本该销毁的对象
- 针对性优化:清理容器、断开引用、手动 del、重启策略
(6)内存泄漏通用解决方案
-
及时断开无用引用
短生命周期对象坚决不存入全局容器,临时变量使用完毕主动
del释放引用 -
容器限量、定时清理
全局缓存、日志队列、任务队列,设置最大长度、定时清空、LRU 淘汰策略
-
避免循环引用
业务代码尽量不要手写
__del__方法,规避 GC 回收失效陷阱 -
长任务分片处理
读取大文件、大批量数据,禁止一次性加载,使用迭代器、分片读取,规避瞬时 OOM
参考视频
[1] 哔哩哔哩 | 大熊课堂 | Python 中的 with语句