§ Essay
Agent 的意图识别如何做?
讲解 Agent 意图识别的工程落地思路,对比纯规则、大模型方案优缺点,介绍分层识别架构与常见实现方案
本文结合网上讲解 Agent 意图识别的工程落地思路,对比纯规则、大模型方案优缺点,介绍分层识别架构(规则层、上下文层、大模型工具层)与结构化 Function Call、提示词分类、RAG 检索、模型微调这四类常见实现方案。
一、什么是意图识别
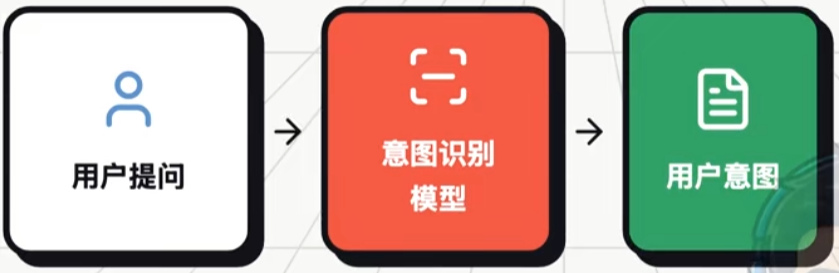
意图识别,是 Agent 接收用户输入之后,第一步要做的核心判断:读懂用户到底想干什么,而不是只读懂字面文字
用户输入是自然语言,往往口语化、省略信息、指代模糊。Agent 需要从这句话里,抽取出用户的目标意图,区分出:是查询信息、执行操作、修改配置,还是闲聊、纠错
举几个直观例子:
-
用户:帮我查下订单
意图:订单查询 -
用户:把刚才那个结果删掉
意图:删除(依赖上下文,“刚才那个” 指代历史内容) -
用户:你觉得这个方案怎么样
意图:咨询评估
意图识别不是简单的文本匹配。它的目标,是把人类模糊的自然语言,映射成 Agent 系统可以理解、可以后续调度工具 / 执行逻辑的结构化指令。
整个 Agent 的后续流程,如工具选择、参数提取、对话状态流转,全都建立在意图识别的结果之上
如果意图判断出错,后面的工具调用、业务执行都会跑偏
2、为什么不能让大模型去猜意图
很多新手开发 Agent 时会采用最简单的方案:所有用户输入全部丢给大模型实时判断意图
看似省事、不用写规则,但在企业落地、高并发、高频对话场景下,存在致命硬伤,完全无法工程化上线
-
延迟:响应极慢
大模型推理需要完整的 Token 计算流程,如果每一句普通对话都走一次 LLM 意图推理,会极大拉高响应耗时。 用户日常高频的简单指令、短句操作,明明可以毫秒级响应,却要等待模型思考,造成肉眼可见的卡顿,完全不符合产品体验标准
-
成本:Token 消耗大
意图识别是每轮对话必触发的前置操作。 如果全部交由大模型处理,海量日常短句、闲聊、简单指令都会持续消耗 Token。 对于企业级高频 Agent 服务,纯大模型判意图会带来成倍的成本爆炸,完全不具备上线规模化能力
-
稳定性:幻觉频发
大模型具备随机性,相同用户输入,不同时刻可能判断出不同意图。 尤其面对模糊口语、省略句式、指代语句,很容易出现:
- 意图判错
- 多意图混淆
- 无中生有乱识别
二、意图识别如何做 —— 分层设计策略
表面上是怎么判断用户想干嘛?实际上是工程上的取舍
意图识别最怕的两个极端:
-
极端一:写死规则
灵活性为 0,换个说法就挂
-
极端二:纯大模型
又贵又慢,不稳定
寻求工程平衡点:
- 准确性
- 延迟
- 成本
1、解决方案
分层设计策略[1]
-
第一层:规则(Rules)
简单请求秒级处理
(绝大多数)
-
第二层:上下文(Context)
常规请求兜住大头
(常规部分)
-
第三层:工具(Tools)
复杂模糊深度判断
(极少数)
越往下越聪明,同时越慢越贵
2、第一层:规则层(Rules)
处理意图明确、表达固定的请求
朴素手段:
- 关键词
- 正则
- 状态机
但是规则不能写太多太死
3、第二层:上下文层(Context)
处理主流流量
“那就这个吧”       -- “这个”指什么?
“还是不行”         -- 对哪件事不行?
技术选型:
- 轻量微调小模型
- 语义向量匹配
比规则灵活,比大模型块,成本更低
工程关键是状态管理(State Management)
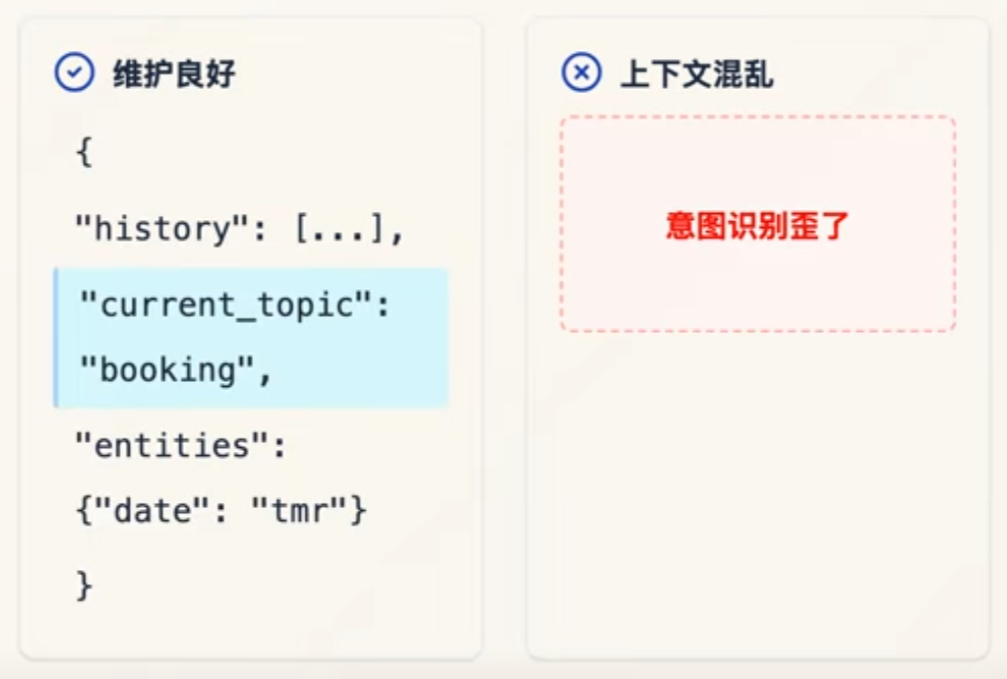
记录当前的任务、已填槽位、历史动作等,新消息来了先更新状态,再判断意图
4、第三层:大模型 + 工具调用层(Tools)
工具兜底,处理最复杂的边缘需求
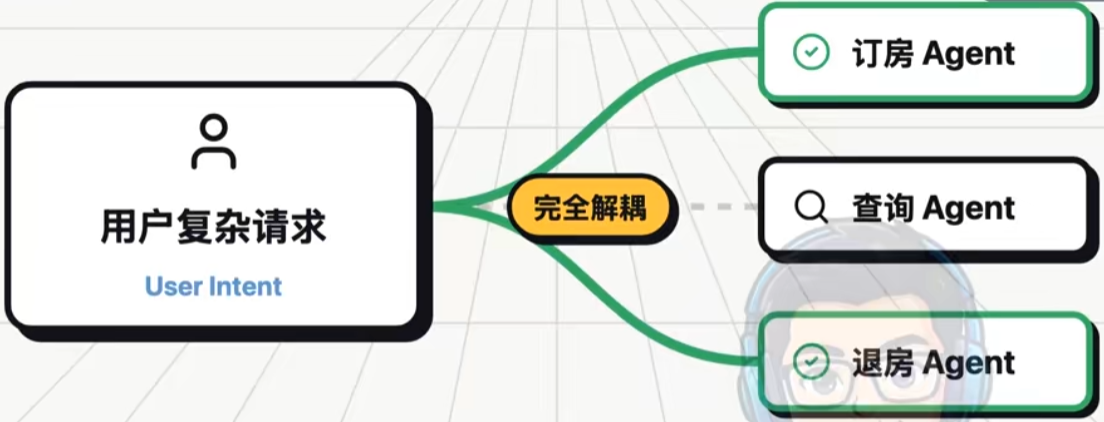
直接将意图与执行打通,大模型理解了用户复杂、模糊、跨多个领域的需求后通过函数调用、MCP 标准协议直接选出调用哪种工具、参数怎么填
三、意图识别常见四种方案
1、结构化 Function Call
结构化输出
假如工具库有两个工具:
- 查天气
- 做菜
用户问:
帮我查北京今天的天气是什么此时大模型就会在工具库中调用“查天气”,并且会将参数自动填充给工具,工具返回结果
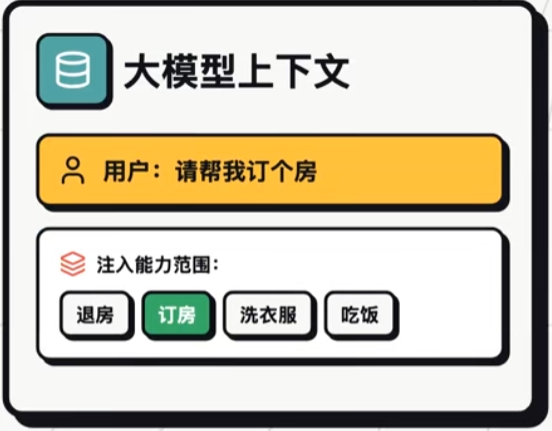
2、提示词分类
3、RAG 检索
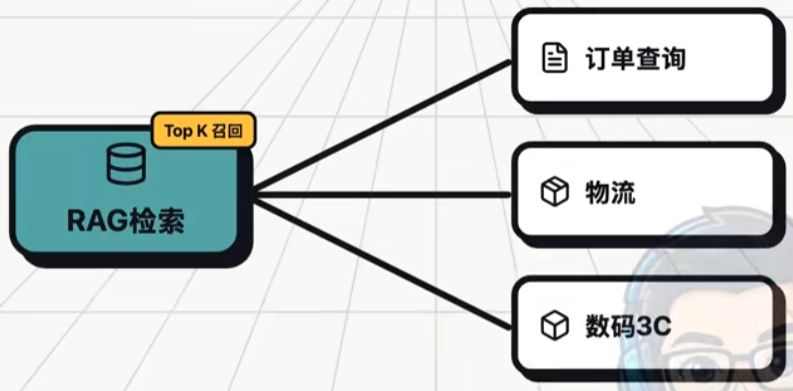
其中(2)、(3)也叫意图识别 + 路由
4、模型微调
单独训练意图识别的模型
四、一段话总结
Agent 的意图识别不能单纯依赖固定规则或者全部交给大模型推理,工程落地推荐采用分层架构:优先用关键词、正则等规则快速处理大量简单明确请求;借助向量匹配、轻量小模型结合对话状态管理承接主流带指代的上下文对话;最后用大模型 + 工具调用兜底处理少量模糊复杂的边缘场景。除此之外还可以选择结构化 Function Call、提示词分类、RAG 检索、模型微调四种实现方案,在识别准确率、响应延迟与服务成本三者之间找到适合业务的平衡点